Assignment 4 Report:Programming a Machine Learning Accelerator(昇腾版)
Assignment 4 要求为机器学习加速器实现并优化 kernel:Part 1(30 分) 用向量加熟悉编程模型与数据搬运,并自己写一个矩阵转置 kernel;Part 2(70 分) 实现融合的 convolution + maxpool 层,中间结果不能落到片外。
课程原始版本面向 AWS Trainium2(NKI)。本报告改为在 华为昇腾 上完成:CANNLab 的一个 NPU(A3 = Ascend 910C,Ascend910_9362)。两个平台的逐项对照、以及每一处"为什么必须这么改"写在配套文档里:
- 作业 README 的昇腾对照版:asst4-ascend/README.md
- Trainium2 ↔ 昇腾 的完整适配说明:asst4-ascend/ascend_adaptation.md
本报告的记号约定:每段可执行的命令都给出真实命令行;
输出:下面的代码块是该命令在本机(CANNLab)上的真实输出。凡是尚未上机执行、需要事后补录的位置,统一用⏳ 待填标注 —— 报告里不写没有实际跑过的结果。
0. 环境配置
0.1 方案选择:CANNLab(替代 AWS Trainium2 容量块)
| 课程原方案(AWS Trainium2) | 本报告方案(华为 CANNLab) | |
|---|---|---|
| 硬件 | trn2.3xlarge,1 颗 Trainium2 = 8 个 NeuronCore |
1 个 NPU(A2 = 910B / A3 = 910C),单卡规格 |
| 获取方式 | 需先启用 ap-southeast-4 区域,再购买 Capacity Block |
注册即可,自助选规格 |
| 费用 | 容量块预付费,约 $2.25/小时,7 天约 $300 | 免费 100 卡时,关机不计时 |
| 编程接口 | NKI(Python DSL,@nki.jit) |
Ascend C(C/C++ 扩展,__global__ __aicore__) |
| 性能剖析 | neuron-profile + InfluxDB + Web GUI(需 SSH 转发 3001/8086) |
msprof op + MindStudio Insight(产出本地目录,无需数据库与端口转发) |
选 CANNLab 的原因很直接:不需要付费容量块、不需要申请白名单,代价是要把 NKI 代码用 Ascend C 重写一遍(这正是配套文档在做的事)。
两点使用约束:
- 本作业是单算子调优,必须选单卡/单 NPU 规格。CANNLab 按"卡时"计费,选 8 卡规格会按卡的倍数扣,100 卡时可用的墙钟时间直接缩到 1/8。
- 用完立刻关机(平台提供闲置自动关机开关)。
0.2 环境确认
登录 CANNLab 后第一件事是确认自己拿到的是哪一代卡 —— 后面 --soc-version、以及在 Tiling 里取的容量值都依赖它。
npu-smi info
A3卡输出:
developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ npu-smi info
+------------------------------------------------------------------------------------------------+
| npu-smi 25.5.5                   Version: 25.5.5                                               |
+---------------------------+---------------+----------------------------------------------------+
| NPU   Name                | Health        | Power(W)    Temp(C)           Hugepages-Usage(page)|
| Chip  Phy-ID              | Bus-Id        | AICore(%)   Memory-Usage(MB)  HBM-Usage(MB)        |
+===========================+===============+====================================================+
| 4     Ascend910           | OK            | 163.0       43                0    / 0             |
| 0     8                   | 0000:0B:00.0  | 0           0    / 0          2908 / 65536         |
+------------------------------------------------------------------------------------------------+
| 4     Ascend910           | OK            | -           42                0    / 0             |
| 1     9                   | 0000:0A:00.0  | 0           0    / 0          2870 / 65536         |
+===========================+===============+====================================================+
+---------------------------+---------------+----------------------------------------------------+
| NPU     Chip              | Process id    | Process name             | Process memory(MB)      |
+===========================+===============+====================================================+
| No running processes found in NPU 4                                                            |
+===========================+===============+====================================================+
A2 卡输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ npu-smi info
+------------------------------------------------------------------------------------------------+
| npu-smi 25.5.1                   Version: 25.5.1                                               |
+---------------------------+---------------+----------------------------------------------------+
| NPU   Name                | Health        | Power(W)    Temp(C)           Hugepages-Usage(page)|
| Chip                      | Bus-Id        | AICore(%)   Memory-Usage(MB)  HBM-Usage(MB)        |
+===========================+===============+====================================================+
| 4     910B4               | OK            | 86.4        34                0    / 0             |
| 0                         | 0000:81:00.0  | 0           0    / 0          2886 / 32768         |
+===========================+===============+====================================================+
+---------------------------+---------------+----------------------------------------------------+
| NPU     Chip              | Process id    | Process name             | Process memory(MB)      |
+===========================+===============+====================================================+
| No running processes found in NPU 4                                                            |
+===========================+===============+====================================================+
echo $ASCEND_HOME_PATH
cat $ASCEND_HOME_PATH/version.info
A3卡输出:
developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ echo $ASCEND_HOME_PATH
/home/developer/Ascend/cann-9.0.0
developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ cat $ASCEND_HOME_PATH/version.info
cat: /home/developer/Ascend/cann-9.0.0/version.info: No such file or directory
说明本机
$ASCEND_HOME_PATH是/home/developer/Ascend/cann-9.0.0(用户目录下的 CANN 9.0.0),版本文件不在根目录,与文档里默认的$ASCEND_HOME_PATH/version.info不一样。所以换成先看目录、再按文件名找:
ls $ASCEND_HOME_PATH
find $ASCEND_HOME_PATH -maxdepth 4 -type f -name "version*"
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ ls $ASCEND_HOME_PATH
aarch64-linux  asc  cann_uninstall.sh  compat    conf    fwkacllib  lib64  ops_uninstall.sh  python   set_env.sh  test-ops  tools
arm64-linux    bin  combo_script       compiler  devlib  include    opp    pkg_inc           runtime  share       toolkit   var

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ find $ASCEND_HOME_PATH -maxdepth 4 -type f -name "version*"
/home/developer/Ascend/cann-9.0.0/opp/version.info
/home/developer/Ascend/cann-9.0.0/python/site-packages/te/version.py
/home/developer/Ascend/cann-9.0.0/tools/msmemscope/version.txt
/home/developer/Ascend/cann-9.0.0/share/info/tbe-tik/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ops_nn/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ge-compiler/version.info
/home/developer/Ascend/cann-9.0.0/share/info/msserviceprofiler/version.info
/home/developer/Ascend/cann-9.0.0/share/info/pyACL/version.info
/home/developer/Ascend/cann-9.0.0/share/info/opbase/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ops_legacy/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ops_cv/version.info
/home/developer/Ascend/cann-9.0.0/share/info/hccl/version.info
/home/developer/Ascend/cann-9.0.0/share/info/hixl/version.info
/home/developer/Ascend/cann-9.0.0/share/info/pto_isa/version.info
/home/developer/Ascend/cann-9.0.0/share/info/mindstudio-operator-tools/version.info
/home/developer/Ascend/cann-9.0.0/share/info/oam_tools/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ops_transformer/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ge-executor/version.info
/home/developer/Ascend/cann-9.0.0/share/info/mindstudio-opprof/version.info
/home/developer/Ascend/cann-9.0.0/share/info/runtime/version.info
/home/developer/Ascend/cann-9.0.0/share/info/dvpp/version.info
/home/developer/Ascend/cann-9.0.0/share/info/mstx/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ms_fmk_transplt/version.info
/home/developer/Ascend/cann-9.0.0/share/info/mspti/version.info
/home/developer/Ascend/cann-9.0.0/share/info/operator_cmp/version.info
/home/developer/Ascend/cann-9.0.0/share/info/aoe/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ops_math/version.info
/home/developer/Ascend/cann-9.0.0/share/info/simulator/version.info
/home/developer/Ascend/cann-9.0.0/share/info/graph_autofusion/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ops_ras/version.info
/home/developer/Ascend/cann-9.0.0/share/info/dflow-executor/version.info
/home/developer/Ascend/cann-9.0.0/share/info/msprof/version.info
/home/developer/Ascend/cann-9.0.0/share/info/asc-devkit/version.info
/home/developer/Ascend/cann-9.0.0/share/info/acl_extend/version.info
/home/developer/Ascend/cann-9.0.0/share/info/metadef/version.info
/home/developer/Ascend/cann-9.0.0/share/info/mindstudio-sanitizer/version.info
/home/developer/Ascend/cann-9.0.0/share/info/msmemscope/version.info
/home/developer/Ascend/cann-9.0.0/share/info/asc-tools/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ncs/version.info
/home/developer/Ascend/cann-9.0.0/share/info/mindstudio-debugger/version.info
/home/developer/Ascend/cann-9.0.0/share/info/hcomm/version.info
/home/developer/Ascend/cann-9.0.0/share/info/test-ops/version.info
/home/developer/Ascend/cann-9.0.0/share/info/bisheng-compiler/version.info
/home/developer/Ascend/cann-9.0.0/share/info/ascendnpu-ir/version.info
然后读版本号。上面 44 个命中里,对作业最有用的是编译器与算子库这两个:
cat $ASCEND_HOME_PATH/compiler/version.info
cat $ASCEND_HOME_PATH/opp/version.info
head -20 $ASCEND_HOME_PATH/aarch64-linux/include/version
# 顺手记下:0.2 的 ls 里有 aarch64-linux/,片上容量的配置文件就在它下面
ls $ASCEND_HOME_PATH/aarch64-linux/data/platform_config/ | head
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ cat $ASCEND_HOME_PATH/compiler/version.info
Version=9.0.0
version_dir=cann
required_package_runtime_version="9.0"
required_package_ge-executor_version="9.0"
required_package_metadef_version="9.0"
required_package_opbase_version="9.0"
required_package_bisheng-compiler_version="9.0"
required_package_tbe-tik_version="9.0"
timestamp=20260428_134817545

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ cat $ASCEND_HOME_PATH/opp/version.info
Version=9.0.0
version_dir=cann
required_package_runtime_version=">=8.5"
required_package_ge-executor_version=">=8.5"
required_package_metadef_version=">=8.5"
required_package_asc-devkit_version=">=8.5"
required_package_bisheng-compiler_version=">=8.5"
timestamp=20260428_134817545

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ head -20 $ASCEND_HOME_PATH/aarch64-linux/include/version
head: error reading '/home/developer/Ascend/cann-9.0.0/aarch64-linux/include/version': Is a directory

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ ls $ASCEND_HOME_PATH/aarch64-linux/data/platform_config/ | head
Ascend031.ini
Ascend035A.ini
Ascend035B.ini
Ascend035.ini
Ascend310B1.ini
Ascend310B2.ini
Ascend310B3.ini
Ascend310B4.ini
Ascend310P1.ini
Ascend310P3.ini
列表里有一处值得注意:
cat $ASCEND_HOME_PATH/compiler/version.info能读到内容,但它不在上面这份-type f列表里(列表里只有opp/version.info和一串share/info/*/version.info)。多半是因为compiler是个符号链接,而find默认不跟随符号链接(要跟随得加-L)。可用ls -ld $ASCEND_HOME_PATH/compiler验证(可选)。版本号前两条已经给全:
compiler/version.info与opp/version.info都是Version=9.0.0,与目录名cann-9.0.0一致。另外
platform_config/那份列表是按字母序排的,head只截到Ascend310P3(031 / 035 / 310 系列);910B、910_93xx(A3)、950 等都在后面,要用的时候直接grep 910或指定文件名读。
A2 卡输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ echo $ASCEND_HOME_PATH
cat $ASCEND_HOME_PATH/version.info
/usr/local/Ascend/cann-8.5.0
cat: /usr/local/Ascend/cann-8.5.0/version.info: No such file or directory
0.3 CANN 环境变量
CANN 的环境脚本有两个位置(根目录的 set_env.sh 与 bin/setenv.bash),先确认再 source。本机两个都在,等价可用:
ls $ASCEND_HOME_PATH/set_env.sh $ASCEND_HOME_PATH/bin/setenv.bash 2>/dev/null
source $ASCEND_HOME_PATH/set_env.sh
which bisheng msprof
# NPU ID 用 npu-smi info 里看到的那个(本机是 4,换个会话可能变,不要写死别的)
npu-smi info -t board -i 4 -c 0
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ ls $ASCEND_HOME_PATH/set_env.sh $ASCEND_HOME_PATH/bin/setenv.bash 2>/dev/null
/home/developer/Ascend/cann-9.0.0/bin/setenv.bash  /home/developer/Ascend/cann-9.0.0/set_env.sh

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ source $ASCEND_HOME_PATH/set_env.sh

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ which bisheng msprof
/home/developer/Ascend/cann-9.0.0/bin/bisheng
/home/developer/Ascend/cann-9.0.0/bin/msprof

developer@8de626ef107b43269a92e55bdfcaea3c:/mnt/workspace$ npu-smi info -t board -i 4 -c 0
        NPU ID                         : 4
        NPU Name                       : 9362
        Chip ID                        : 0
        Chip Name                      : Ascend910
        Chip Version                   : V1
        Board ID                       : 0xb3
        PCB ID                         : NA
        BOM ID                         : 1
        VDie ID                        : 6F43F664 00C10159 7302F8D3 BE0B0B56 144301E3
        NDie ID                        : 00000000 00000000 00000000 00000000 00000000
        Chip Position ID               : 0
        PCIe Bus Info                  : 0000:0B:00.0
        Firmware Version               : NA
→ 由此得到
--soc-version=Ascend910_9362(Chip Name+_+NPU Name)。后面 0.5 的构建和 Step 2b 的msprof都用这个值;换个会话机型可能变,所以这个值要每次现查,不要沿用。
从以上输出里要读出这几个值,后面每一步都会用到:
| 要确定的东西 | 从哪里读 | 本机结果 |
|---|---|---|
机型 / SoC 版本(即 --soc-version) |
npu-smi info 的 Name 列 = Chip Name;npu-smi info -t board -i <NPU ID> -c <chip> 的 NPU Name;两者拼成 Chip Name_NPU Name |
Ascend910_9362(Chip Name Ascend910 + NPU Name 9362) |
| die 数(Chip Count) | npu-smi info;A2 = 1,A3 = 2 |
2(Chip 0 与 Chip 1)→ 双 die,即 A3 = Ascend 910C |
| 单 die 显存 | npu-smi info 的 HBM-Usage(MB) 分母 |
65536 MB = 64 GB / chip |
| CANN 版本 | $ASCEND_HOME_PATH 目录名 + compiler/version.info / opp/version.info |
9.0.0(两份 version.info 都是 Version=9.0.0,与目录名一致) |
| 工具链可执行文件 | which bisheng msprof |
$ASCEND_HOME_PATH/bin/bisheng(编 kernel 的编译器)、$ASCEND_HOME_PATH/bin/msprof(剖析) |
| NPU 驱动 / npu-smi 版本 | npu-smi info 第一行 |
25.5.5 |
| NPU ID / Chip ID | npu-smi info(每次会话可能变,不要硬编码) |
NPU ID = 4;Chip 0(Phy-ID 8,0000:0B:00.0)、Chip 1(Phy-ID 9,0000:0A:00.0) |
判机型只能靠
npu-smi。platform_config/目录里有 60 多份不同 SoC 的配置(含 910A/910B/A3/950/310/Kirin),它是编译器的查找表,不是当前机器的型号证据。
0.4 代码位置
Part 1 的代码在 asst4-ascend/part1/(对应 Trainium2 版的 asst4-trainium2/part1/):
| 文件 | 作用 |
|---|---|
kernels.cpp |
Ascend C kernel:vector_add_single / vector_add_stream / matrix_transpose |
main.cpp |
Host 驱动:分配显存、造数据、启动 kernel、计时、输出 JSON |
run_benchmark.py |
命令行:构建、传参、解析结果、msprof 采集、numpy 对拍 |
CMakeLists.txt、cmake/、run.sh |
构建(与官方 *_kernellaunch 样例结构一致) |
0.5 构建
--soc-version 用 0.2 里确定的那个值。
cd asst4-ascend/part1
bash run.sh --soc-version Ascend910_9362 --build-only
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ bash run.sh --soc-version Ascend910_9362 --build-only
-- [npu_lib] ASCENDC_CMAKE_DIR = /home/developer/Ascend/cann-9.0.0/compiler/tikcpp/ascendc_kernel_cmake
-- [npu_lib] SOC_VERSION      = Ascend910_9362
-- [npu_lib] KERNEL_FILES     = /mnt/workspace/asst4-ascend/part1/kernels.cpp
...(省略 3 行 CMake / ExternalProject 样板输出)...
[  2%] Performing build step for 'ascendc_kernels_npu_precompile'
Consolidate compiler generated dependencies of target precompile_obj
[100%] Building CXX object CMakeFiles/precompile_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[100%] Built target precompile_obj
[100%] Built target check_src_template
[  4%] No install step for 'ascendc_kernels_npu_precompile'
[  6%] Completed 'ascendc_kernels_npu_precompile'
[ 18%] Built target ascendc_kernels_npu_precompile
[ 20%] Performing build step for 'ascendc_kernels_npu_preprocess'
...(省略 3 行 CMake / ExternalProject 样板输出)...
Consolidate compiler generated dependencies of target aic_obj
Consolidate compiler generated dependencies of target preprocess_obj
Consolidate compiler generated dependencies of target aiv_obj
[ 33%] Building CXX object CMakeFiles/aic_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[ 66%] Building CXX object CMakeFiles/preprocess_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[100%] Building CXX object CMakeFiles/aiv_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[100%] Built target preprocess_obj
[100%] Built target aic_obj
[100%] Built target aiv_obj
/home/developer/Ascend/cann-9.0.0/aarch64-linux/ccec_compiler/bin/ld.lld -m aicorelinux -Ttext=0 /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_preprocess-prefix/src/ascendc_kernels_npu_preprocess-build/CMakeFiles/aic_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o -o /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_preprocess-prefix/src/ascendc_kernels_npu_preprocess-build/CMakeFiles/aic_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o/home/developer/Ascend/cann-9.0.0/aarch64-linux/ccec_compiler/bin/ld.lld -m aicorelinux -Ttext=0 /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_preprocess-prefix/src/ascendc_kernels_npu_preprocess-build/CMakeFiles/aiv_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o -o /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_preprocess-prefix/src/ascendc_kernels_npu_preprocess-build/CMakeFiles/aiv_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o[100%] Built target merge_aiv_obj_text
[100%] Built target merge_aic_obj_text
[WARNING]: Multiple kernel functions are detected. It is recommended to define only one kernel function per file.
[100%] Built target _host_cpp
[ 22%] No install step for 'ascendc_kernels_npu_preprocess'
[ 25%] Completed 'ascendc_kernels_npu_preprocess'
[ 36%] Built target ascendc_kernels_npu_preprocess
...(省略 12 行 CMake / ExternalProject 样板输出)...
[ 65%] Performing configure step for 'ascendc_kernels_npu_aiv_device'
[ 68%] Performing configure step for 'ascendc_kernels_npu_aic_device'
[ 70%] Performing configure step for 'ascendc_kernels_npu_host'
...(省略 41 行 CMake / ExternalProject 样板输出)...
CMake Warning:
  Manually-specified variables were not used by the project:

    ASCEND_PYTHON_EXECUTABLE


CMake Warning:
  Manually-specified variables were not used by the project:

    BUILD_MODE


...(省略 4 行 CMake / ExternalProject 样板输出)...
[ 72%] Performing build step for 'ascendc_kernels_npu_aic_device'
[ 75%] Performing build step for 'ascendc_kernels_npu_host'
[ 77%] Performing build step for 'ascendc_kernels_npu_aiv_device'
[ 79%] No install step for 'ascendc_kernels_npu_aic_device'
[100%] Building CXX object CMakeFiles/host_bisheng_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[100%] Building CXX object CMakeFiles/device_aiv_obj.dir/mnt/workspace/asst4-ascend/part1/build-npu/auto_gen/ascendc_kernels_npu/auto_gen_kernels.cpp.o
[ 81%] Completed 'ascendc_kernels_npu_aic_device'
[ 81%] Built target ascendc_kernels_npu_aic_device
[100%] Built target host_bisheng_obj
[ 84%] Performing install step for 'ascendc_kernels_npu_host'
Consolidate compiler generated dependencies of target host_bisheng_obj
[100%] Building CXX object CMakeFiles/host_bisheng_obj.dir/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[100%] Built target host_bisheng_obj
Install the project...
-- Install configuration: "Release"
-- Installing: /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_host_dir/./objects-Release/host_bisheng_obj/mnt/workspace/asst4-ascend/part1/kernels.cpp.o
[ 86%] Completed 'ascendc_kernels_npu_host'
[ 86%] Built target ascendc_kernels_npu_host
[100%] Built target device_aiv_obj
/home/developer/Ascend/cann-9.0.0/aarch64-linux/ccec_compiler/bin/ld.lld  -m aicorelinux -r  -Ttext=0 /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_aiv_device-prefix/src/ascendc_kernels_npu_aiv_device-build/CMakeFiles/device_aiv_obj.dir/mnt/workspace/asst4-ascend/part1/build-npu/auto_gen/ascendc_kernels_npu/auto_gen_kernels.cpp.o -static -o /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_aiv_device_dir/device_aiv.o
[100%] Built target merge_aiv_device_obj
[ 88%] No install step for 'ascendc_kernels_npu_aiv_device'
[ 90%] Completed 'ascendc_kernels_npu_aiv_device'
[ 90%] Built target ascendc_kernels_npu_aiv_device
/home/developer/Ascend/cann-9.0.0/aarch64-linux/ccec_compiler/bin/ld.lld -x -m aicorelinux   -Ttext=0 /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_aiv_device_dir/device_aiv.o -static -o /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_merge_obj_dir/device_aiv.o
[ 90%] Built target ascendc_kernels_npu_merge_obj
[ 93%] Building CXX object CMakeFiles/ascendc_kernels_npu_host_stub_obj.dir/auto_gen/ascendc_kernels_npu/host_stub.cpp.o
[ 93%] Built target ascendc_kernels_npu_host_stub_obj
[ 95%] Linking CXX shared library lib/libascendc_kernels_npu.so
/home/developer/Ascend/cann-9.0.0/bin/ascendc_pack_kernel /mnt/workspace/asst4-ascend/part1/build-npu/CMakeFiles/ascendc_kernels_npu_host_stub_obj.dir/auto_gen/ascendc_kernels_npu/host_stub.cpp.o /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_merge_obj_dir/device_aiv.o 1 /mnt/workspace/asst4-ascend/part1/build-npu/CMakeFiles/ascendc_kernels_npu_host_stub_obj.dir/auto_gen/ascendc_kernels_npu/host_stub.cpp.o
recompile: /usr/bin/c++ -fPIC -O3 -DNDEBUG -Wl,-z,relro -Wl,-z,now -Wl,-z,noexecstack -s -shared -Wl,-soname,libascendc_kernels_npu.so -o lib/libascendc_kernels_npu.so CMakeFiles/ascendc_kernels_npu_host_stub_obj.dir/auto_gen/ascendc_kernels_npu/host_stub.cpp.o /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels_npu_host_dir/objects-Release/host_bisheng_obj/mnt/workspace/asst4-ascend/part1/kernels.cpp.o    -L/home/developer/Ascend/cann-9.0.0/lib64  -L/home/developer/Ascend/cann-9.0.0/tools/simulator/Ascend910_9362/lib  /home/developer/Ascend/cann-9.0.0/lib64/libascendc_runtime.a -lascend_dump -lc_sec
[ 95%] Built target ascendc_kernels_npu
[ 97%] Building CXX object CMakeFiles/ascendc_kernels.dir/main.cpp.o
[100%] Linking CXX executable ascendc_kernels
[100%] Built target ascendc_kernels
[INFO ] 构建完成:/mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels
一处 WARNING,说明一下:
[WARNING]: Multiple kernel functions are detected. It is recommended to define only one kernel function per file.因为
kernels.cpp里定义了 3 个__global__核函数(vector_add_single、vector_add_stream、matrix_transpose),而 CANN 的构建系统建议一个文件只放一个核函数。这只是建议:紧接着的
[100%] Built target ascendc_kernels表明构建照常成功。之所以这么组织,是为了让三个入口共用同一份类模板实现(见 Part 1 的代码说明);等到 Part 2 核函数变多、或需要走ACLRT_LAUNCH_KERNEL自动生成启动桩时,再按核函数拆文件更稳妥。运行期的库搜索路径(上板前必踩的一步):kernel 被编成
build-npu/lib/libascendc_kernels_npu.so,可执行文件链接了它,但运行时不一定会去那个目录找 —— 直接跑会得到build-npu/ascendc_kernels: error while loading shared libraries: libascendc_kernels_npu.so: cannot open shared object file: No such file or directory [ERROR] kernel 执行失败(exit 127)原因是 NPU 侧的
ascendc_library()不把输出位置告诉 CMake,所以 CMake 不会像 CPU 侧那样自动给可执行文件加 RPATH。官方样例的run.sh是在运行前export LD_LIBRARY_PATH=$(pwd)/out/lib:$(pwd)/out/lib64:${_ASCEND_INSTALL_PATH}/lib64:$LD_LIBRARY_PATH。本仓库两处都补上了:run_benchmark.py运行子进程时自己设(run_env()),CMakeLists.txt里也设了BUILD_RPATH(手工./build-npu/ascendc_kernels也能跑)。另外三类
CMake Warning也不是本工程的问题(它们在日志里出得很显眼,说明一下免得误判):Manually-specified variables were not used by the project: DYNAMIC_MODE / INCLUDE_DIR ← 出现在 ascendc_kernels_npu_precompile 子工程的 configure 之后 BUILD_MODE ← 出现在 ascendc_kernels_npu_aic_device 子工程的 configure 之后 ASCEND_PYTHON_EXECUTABLE ← 出现在 ascendc_kernels_npu_host 子工程的 configure 之后CANN 的
ascendc.cmake会用ExternalProject拉起 5 个子工程(precompile / preprocess / aic_device / aiv_device / host),转发给每个子工程的变量是一整串,而子工程只用其中一部分 —— CMake 就替"用不到的那几个"各发一次提示。判断依据:我们自己的那次 configure(打印
[npu_lib] ASCENDC_CMAKE_DIR = ...那一段)后面没有这类 warning,它们全都紧跟在子工程的Generating done之后。属于"传多了"的无害提示,不需要修(要修就得改 CANN 安装目录下的 cmake 文件,得不偿失)。
0.6 CPU 域孪生调试(省卡时的关键路径)
Ascend C 支持把同一份 kernels.cpp 编到 CPU 上执行(ICPU_RUN_KF),用来做正确性对拍。编译器错误、对齐问题、精度问题都应该在这一步解决,不要上板调试。
cd asst4-ascend/part1
python3 run_benchmark.py --kernel tiled -n 25600 --run-mode cpu

# 如果需要重新build的话
python3 run_benchmark.py --kernel tiled -n 25600 --run-mode cpu --build
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel tiled -n 25600 --run-mode cpu --build
[INFO ] 构建中(soc-version=Ascend910_9362)...
-- [cpu_lib] tikicpulib cmake dir = /home/developer/Ascend/cann-9.0.0/tools/tikicpulib/lib/cmake
-- Configuring done
-- Generating done
-- Build files have been written to: /mnt/workspace/asst4-ascend/part1/build-cpu
Consolidate compiler generated dependencies of target ascendc_kernels_cpu
[ 50%] Built target ascendc_kernels_cpu
Consolidate compiler generated dependencies of target ascendc_kernels
[ 75%] Building CXX object CMakeFiles/ascendc_kernels.dir/main.cpp.o
[100%] Linking CXX executable ascendc_kernels
[100%] Built target ascendc_kernels
[INFO ] 构建完成:/mnt/workspace/asst4-ascend/part1/build-cpu/ascendc_kernels
[INFO ] CPU 域执行:/mnt/workspace/asst4-ascend/part1/build-cpu/ascendc_kernels --kernel single --n 25600 --m 25600 --tile 25600 --block-dim 1 --out /mnt/workspace/asst4-ascend/part1/out/tiled.bin
[TmSim]: Run in serial mode.
[SUCCESS][CORE_0][pid 6064] exit success!
[INFO ] CPU 域执行完成(不产生耗时数据),输出已写入 /mnt/workspace/asst4-ascend/part1/out/tiled.bin

kernel      : tiled  (CPU 域孪生调试,无耗时数据)
tile        : 25600 个元素
[ OK ] 结果与 numpy 参考一致
结果:CPU 域对拍通过 ——
vector_add_single(tile = 25600、单缓冲、blockDim = 1)的输出与 numpy 参考逐元素一致。这一步验证的是数值逻辑(是否真的算了z = x + y、有没有对齐/尾块问题),耗时数据要等上板。
0.7 收尾
npu-smi info          # 确认没有残留任务
# 然后在 CANNLab 控制台关机(关机不计时)
1. Part 1: Learning the Ascend C Kernel Interface with Vector Add and Matrix Transpose(30 分)
Part 1 要回答三个问题:分块(Step 1)、搬运粒度与流水(Step 2a/2b)、矩阵转置(Step 3)。本报告逐一记录命令与实测数据。
被测代码与参数含义(对应 Trainium2 版的 ROW_CHUNK / FREE_DIM):
| 本报告用到的开关 | 含义 | Trainium2 版的对应物 |
|---|---|---|
--kernel naive |
单缓冲,tile = 16(最小合法分块) |
vector_add_tiled 且 ROW_CHUNK = 1 |
--kernel tiled --tile T |
单缓冲,单次搬 T 个元素 | vector_add_tiled 且 ROW_CHUNK = T |
--kernel stream --tile T |
双缓冲(BUFFER_NUM = 2),单次搬 T 个元素 |
vector_add_stream 且 FREE_DIM ≈ T/128 |
--block-dim B |
用 B 个 AI Core(SPMD 并行度) | 无对应物(NKI 版是单核) |
单位约定:本文的内存容量一律用二进制单位(1 KiB = 1024 B、1 MiB = 1024 KiB),硬件文档里的 "192 KB" 指的就是 192 KiB = 196608 B。而
run_benchmark.py打印的 MB 是十进制(moved_bytes / 1e6),带宽 GB/s 也是十进制。两者不要混——153600 B既等于 150 KiB,也等于 0.154 MB(十进制),是同一个数。一个必须先记住的平台差异:
--tile的最小值是 16,不是 1。因为昇腾的DataCopy最小搬运粒度是 32 B = 1 个 DataBlock = 16 个 half,所以 Trainium2 版里ROW_CHUNK = 1这种"一次搬一个元素"的写法在昇腾上连合法都做不到。两边的"最小分块"因此在数值上就差了 16 倍。
1.1 Step 1: Chunking Vectors to Parallelize(6 分)
对应原版 Step 1 的三问,在昇腾上改问:
- 最小合法分块(
tile = 16)跑 25600 个元素,耗时多少? - 逐步放大
tile直到接近 UB 能装下的上限,耗时降到多少?相比第 1 问快了多少?为什么? - 继续放大到超过 UB 容量,会看到什么报错?为什么?
1.1.1 最小合法分块:tile = 16
cd asst4-ascend/part1
python3 run_benchmark.py --kernel naive -n 25600 --verify
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel naive -n 25600 --verify

kernel      : naive  (可执行文件里的入口: single)
n           : 25600
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 1 个 AI Core
latency     : median 404.687 us   min 400.827 us   avg 404.772 us
bandwidth   : 0.38 GB/s  (按访存量 0.154 MB 估算)
[ OK ] 结果与 numpy 参考一致
如果修改了代码,先做一次带重新配置的构建(RPATH 改动需要重新 cmake),然后上板:
python3 run_benchmark.py --kernel naive -n 25600 --verify --build
如果还想亲眼确认一下诊断,先跑这两条:
ls build-npu/lib/                                       # 应该能看到 libascendc_kernels_npu.so
ldd build-npu/ascendc_kernels | grep ascendc_kernels     # 修复前应显示 "not found"
1.1.2 放大 tile(单缓冲)
--tile 必须是 16 的整数倍、且能整除 -n。25600 = 2^10 × 5^2,满足条件的取值有 21 个,下面挑几档有代表性的逐档跑:
cd asst4-ascend/part1

for T in 16 128 1024 6400 12800 25600; do echo "===== tile=$T"; python3 run_benchmark.py --kernel tiled -n 25600 --tile $T; done
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ for T in 16 128 1024 6400 12800 25600; do echo "===== tile=$T"; python3 run_benchmark.py --kernel tiled -n 25600 --tile $T; done
===== tile=16

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 1 个 AI Core
latency     : median 403.687 us   min 400.818 us   avg 404.640 us
bandwidth   : 0.38 GB/s  (按访存量 0.154 MB 估算)
===== tile=128

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 128 个元素  (单次搬运 256 B)
block-dim   : 1 个 AI Core
latency     : median 70.492 us   min 68.421 us   avg 70.479 us
bandwidth   : 2.18 GB/s  (按访存量 0.154 MB 估算)
===== tile=1024

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 1024 个元素  (单次搬运 2048 B)
block-dim   : 1 个 AI Core
latency     : median 27.620 us   min 23.771 us   avg 27.738 us
bandwidth   : 5.56 GB/s  (按访存量 0.154 MB 估算)
===== tile=6400

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 6400 个元素  (单次搬运 12800 B)
block-dim   : 1 个 AI Core
latency     : median 25.630 us   min 16.401 us   avg 21.790 us
bandwidth   : 5.99 GB/s  (按访存量 0.154 MB 估算)
===== tile=12800

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 12800 个元素  (单次搬运 25600 B)
block-dim   : 1 个 AI Core
latency     : median 24.710 us   min 14.071 us   avg 22.090 us
bandwidth   : 6.22 GB/s  (按访存量 0.154 MB 估算)
===== tile=25600

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 25600 个元素  (单次搬运 51200 B)
block-dim   : 1 个 AI Core
latency     : median 22.731 us   min 16.670 us   avg 24.314 us
bandwidth   : 6.76 GB/s  (按访存量 0.154 MB 估算)
汇总表(从上面的输出里抄 median_us):
| tile(元素) | 单次搬运字节数 | DataCopy 次数(x/y/z 合计) | median 耗时(μs) | min 耗时(μs) | 加速比(median 口径) |
|---|---|---|---|---|---|
| 16 | 32 B | 4800 | 403.687 | 400.818 | 1.00× |
| 128 | 256 B | 600 | 70.492 | 68.421 | 5.73× |
| 1024 | 2048 B(2 KiB) | 75 | 27.620 | 23.771 | 14.62× |
| 6400 | 12800 B(12.5 KiB) | 12 | 25.630 | 16.401 | 15.75× |
| 12800 | 25600 B(25 KiB) | 6 | 24.710 | 14.071 | 16.34× |
| 25600 | 51200 B(50 KiB) | 3 | 22.731 | 16.670 | 17.76× |
1.1.3 超过 UB 容量
单缓冲下三个张量(x/y/z)各占 tile × 2 B,UB 容量 192 KiB。先取 tile = 32768 —— 三个张量合计 3 × 32768 × 2 = 196608 B,正好把 192 KiB 占满,先看它能不能过:
python3 run_benchmark.py --kernel tiled -n 65536 --tile 32768
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel tiled -n 65536 --tile 32768

kernel      : tiled  (可执行文件里的入口: single)
n           : 65536
tile        : 32768 个元素  (单次搬运 65536 B)
block-dim   : 1 个 AI Core
latency     : median 32.601 us   min 22.121 us   avg 29.107 us
bandwidth   : 12.06 GB/s  (按访存量 0.393 MB 估算)
它没有挂 —— 三个张量正好把 192 KiB 占满,装得下。那就再取一个肯定超的(384 KiB,是 UB 的 2 倍):
python3 run_benchmark.py --kernel tiled -n 131072 --tile 65536
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel tiled -n 131072 --tile 65536
/mnt/workspace/asst4-ascend/part1/main.cpp:252 aclError:507035
[ERROR] kernel 执行失败(exit 1)
main.cpp:252那一行是CHECK_ACL(aclrtSynchronizeStream(stream)),也就是说:kernel 启动指令下发成功了,是执行时在设备侧出错,等 stream 时把错误抛了上来。507035在昇腾官方案例库里对应的现象是 "Synchronize stream failed"(设备侧执行失败,plog 里还能看到aic error code=0x8000000000000000)。放到本次的上下文里,原因很直接:3 × 65536 × 2 B = 393216 B = 384 KiB,是 UB 容量的 2 倍。UB 容量的两个口径、
GetCoreMemSize()的语义、以及ReserveLocalMemory()是否强制 kernel,这一组平台侧的调查整理在 asst4-ascend/README.md 的 Memory Hierarchy 一节。
1.1.4 结果分析
(1)加速比从哪来:摊薄的是"固定开销",不是"数据量"
三次实验搬运的数据量完全相同(x + y + z = 3 × 51200 B = 153600 B = 150 KiB),唯一变量是一次搬多少元素。tile 从 16 涨到 25600(1600 倍),耗时只降到 1/17.8——因为瓶颈从来不是数据量,而是每次迭代的固定成本被支付了多少遍:
| tile = 16 | tile = 25600 | |
|---|---|---|
| 内核里的迭代次数 | 1600 | 1 |
| 每次迭代的指令 | 3 × DataCopy(各 32 B)+ 1 × Add(16 元素) |
3 × DataCopy(各 50 KB)+ 1 × Add(25600 元素) |
| 合计指令数 | 6400 条 | 4 条 |
同一份工作量,指令条数差了 1600 倍。这就是 tile=16 → 128 那一档跳得最猛(5.73×)的原因:搬运的建立开销与指令发射开销被摊薄的次数一下子多了 8 倍。
(2)22.7 μs 不是 kernel 的净耗时,是"启动 + 同步"的地板
0.154 MB 的搬运量,哪怕一颗 AI Core 的 MTE 带宽只有 100 GB/s,也只需约 1.5 μs;而实测中位 22.7 μs、最小 14.1 μs。差一个数量级,说明测到的主要不是 kernel 本身:main.cpp 每轮是 launch() → aclrtSynchronizeStream() → 读时间,把 kernel 下发、调度、同步的往返全算了进去。
两处旁证:
- min 与 median 差距很大:tile = 6400 时 min 16.401 / median 25.630(差 56%),tile = 12800 时 min 14.071 / median 24.710(差 76%)。min 剔掉了宿主侧抖动,更接近 kernel 本体。
- 按 min 排序,最优点不在最大 tile:min 口径的加速比是 12800(28.5×)> 6400(24.4×)≈ 25600(24.0×)> 1024(16.9×)。也就是说 tile 超过 12800 之后,kernel 本体反而略微变慢。
这个反转有明确的物理原因:tile = 25600 时内核只迭代 1 次,MTE2(搬入)/ Vector(计算)/ MTE3(搬出)没有任何跨迭代的重叠机会,三段流水完全串行;而 tile = 12800 / 6400 有 2 / 4 次迭代,后一轮的搬入可以和前一轮的计算重叠起来。
另外 tile = 25600 时三个张量占 3 × 51200 B = 150 KiB,UB(192 KiB)已用掉 78%,也留不出双缓冲的空间。——这正是 Step 2a(流水)与 Step 2b(剖析)要展开的问题。
顺带印证:1.1.3 里
tile = 32768能过,恰好是3 × 64 KB = 192 KB,把 UB 正好占满。
(3)表里的带宽数字怎么读
0.38 GB/s → 6.76 GB/s 是按 153600 B ÷ median 算的有效带宽(GB/s 按十进制 10⁹ 计),因为分母含固定启动开销,它不代表这颗芯片或这个 kernel 的访存上限。真实的上限要用 msprof 看 MTE 带宽利用率(Step 2b)。
(4)一个被本步骤固定住的变量:只用了 1 个 AI Core
全程 --block-dim 1,即 20 个 AI Core 里只用 1 个。在Trainium2中,Step 1 的标题是 "Parallelize Across 128 Compute Lanes",讲的是核内 128 条 lane 的并行;
而昇腾(高维切分 API):
Vector 计算单元每个迭代会从 UB 中取出 8 个 datablock(每个 datablock 数据块内部地址连续,长度 32 Byte)
mask参数: 当前数据类型单次迭代时能处理的元素个数最大值为:256 / sizeof(数据类型)。当操作数占 16 位时,mask ∈ [1, 128]
昇腾核内没有"128 条 lane"这个固定说法:如上面引文所示,宽度是按字节给的(每次迭代 256 B,half 合 128 个元素、float 合 64 个),要处理更多元素靠 repeatTime 迭代。
昇腾另外多出一层核间并行——这是 NKI 单核语义里没有的旋钮。本步骤先固定 block-dim = 1,是为了与 Trainium2 版的单核语义保持可比;核间这一维留到后面(或作为加分项)再考虑。
本节结论:
- 最小合法分块(tile = 16)跑 25600 个元素:median 403.687 μs(与
--kernel naive的 404.687 μs 一致,两者本来就是同一个 kernel + 同一个 tile)。 - 放大到 UB 装得下的最大值:median 22.731 μs,快 17.76×。快的原因是固定开销被摊薄(指令数从 6400 条降到 4 条),不是因为搬得更快。
- 超过 UB 容量:kernel 会在设备侧执行失败(
main.cpp:252 aclError:507035),而不是 host 侧的参数错误 ——aclrtSynchronizeStream报 "Synchronize stream failed"。
1.2 Step 2a: Improved Data Streaming(4 分)
Trainium版 Step 2a 的做法是把一维向量 reshape 成 (128, FREE_DIM),让一次 dma_copy 搬更多数据,从而摊薄 DMA 传输的建立开销。昇腾的 DataCopy 本身就是"一次搬 tileLength 个元素",没有分区维/自由维这套二维语义,于是这一步在昇腾上要拆成两个独立的旋钮分别测量:
| 旋钮 | 本报告怎么拧 | 对应原版的什么 |
|---|---|---|
| 搬运粒度 | --tile(单次搬运的元素数) |
FREE_DIM |
| 流水深度 | --kernel tiled(BUFFER_NUM = 1,搬完再算) vs --kernel stream(= 2,双缓冲) |
原版没有显式对应物(affine_range 由编译器优化) |
一个必须先算清的约束:双缓冲要占两份 UB,6 × tile × 2 B ≤ 196608 B,所以双缓冲下 tile ≤ 16384——正好是单缓冲上限(32768)的一半。
1.2.1 同 tile 下:单缓冲 vs 双缓冲
cd ~/asst4-ascend/part1

for T in 1280 3200 6400 12800; do echo "== tile=$T 单缓冲"; python3 run_benchmark.py --kernel tiled -n 25600 --tile $T --verify; echo "== tile=$T 双缓冲"; python3 run_benchmark.py --kernel stream -n 25600 --tile $T --verify; done
输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ for T in 1280 3200 6400 12800; do echo "== tile=$T 单缓冲"; python3 run_benchmark.py --kernel tiled -n 25600 --tile $T --verify; echo "== tile=$T 双缓冲"; python3 run_benchmark.py --kernel stream -n 25600 --tile $T --verify; done
== tile=1280 单缓冲

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 1280 个元素  (单次搬运 2560 B)
block-dim   : 1 个 AI Core
latency     : median 27.950 us   min 21.840 us   avg 28.856 us
bandwidth   : 5.50 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=1280 双缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 1280 元素 × 2 B × 2 缓冲 = 15360 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 25600
tile        : 1280 个元素  (单次搬运 2560 B)
block-dim   : 1 个 AI Core
latency     : median 22.481 us   min 19.500 us   avg 23.222 us
bandwidth   : 6.83 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=3200 单缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 3200 元素 × 2 B × 1 缓冲 = 19200 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 3200 个元素  (单次搬运 6400 B)
block-dim   : 1 个 AI Core
latency     : median 20.930 us   min 19.070 us   avg 23.313 us
bandwidth   : 7.34 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=3200 双缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 3200 元素 × 2 B × 2 缓冲 = 38400 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 25600
tile        : 3200 个元素  (单次搬运 6400 B)
block-dim   : 1 个 AI Core
latency     : median 27.870 us   min 16.040 us   avg 24.734 us
bandwidth   : 5.51 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=6400 单缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 6400 元素 × 2 B × 1 缓冲 = 38400 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 6400 个元素  (单次搬运 12800 B)
block-dim   : 1 个 AI Core
latency     : median 20.050 us   min 19.210 us   avg 22.898 us
bandwidth   : 7.66 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=6400 双缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 6400 元素 × 2 B × 2 缓冲 = 76800 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 25600
tile        : 6400 个元素  (单次搬运 12800 B)
block-dim   : 1 个 AI Core
latency     : median 26.380 us   min 19.451 us   avg 25.060 us
bandwidth   : 5.82 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=12800 单缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 12800 元素 × 2 B × 1 缓冲 = 76800 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 12800 个元素  (单次搬运 25600 B)
block-dim   : 1 个 AI Core
latency     : median 20.020 us   min 19.790 us   avg 22.166 us
bandwidth   : 7.67 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
== tile=12800 双缓冲
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 12800 元素 × 2 B × 2 缓冲 = 153600 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 25600
tile        : 12800 个元素  (单次搬运 25600 B)
block-dim   : 1 个 AI Core
latency     : median 21.761 us   min 19.520 us   avg 23.508 us
bandwidth   : 7.06 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
[ OK ] 结果与 numpy 参考一致
输出汇总:
| tile | 迭代数 | 单缓冲 median / min(μs) | 双缓冲 median / min(μs) | 双/单(median) | 双/单(min) |
|---|---|---|---|---|---|
| 1280 | 20 | 27.950 / 21.840 | 22.481 / 19.500 | 0.80× | 0.89× |
| 3200 | 8 | 20.930 / 19.070 | 27.870 / 16.040 | 1.33× | 0.84× |
| 6400 | 4 | 20.050 / 19.210 | 26.380 / 19.451 | 1.32× | 1.01× |
| 12800 | 2 | 20.020 / 19.790 | 21.761 / 19.520 | 1.09× | 0.99× |
1.2.2 双缓冲把上限砍半(验证容量约束)
# 应当通过档
python3 run_benchmark.py --kernel stream -n 32768 --tile 16384 --verify
# 越界档
python3 run_benchmark.py --kernel stream -n 32800 --tile 16400 --verify
输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel stream -n 32768 --tile 16384 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 16384 元素 × 2 B × 2 缓冲 = 196608 B  → 已超过 GetCoreMemSize 报的可用量
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 32768
tile        : 16384 个元素  (单次搬运 32768 B)
block-dim   : 1 个 AI Core
latency     : median 20.930 us   min 14.510 us   avg 23.051 us
bandwidth   : 9.39 GB/s  (按访存量 196608 B = 0.188 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel stream -n 32800 --tile 16400 --verify
[WARN ] 三个队列共需 196800 B(3 张量 × 16400 元素 × 2 B × 2 缓冲)> UB 上限 196608 B
         预计会在设备侧失败,报 aclError:507035(Synchronize stream failed)。
         真实上限可用 --ub-size 覆盖;910B/910C 实测为 196608 B。
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 16400 元素 × 2 B × 2 缓冲 = 196800 B  → 已超过 GetCoreMemSize 报的可用量
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。
/opt/atomgit/asst4-ascend/part1/main.cpp:329 aclError:507035
[ERROR] kernel 执行失败(exit 1)
注:越界档必须满足 tile 是 16 的整数倍 且能整除
n。上一版写的--tile 16392不是 16 的倍数(16×1024.5),被 harness 的校验拦下——这正是这条规则存在的意义。修正为 16400 = 16 × 1025,配n = 32800 = 2 × 16400。
6 × 16384 × 2 = 196608 B(正好占满、双缓冲合法上限)通过;6 × 16400 × 2 = 196800 B(超 192 B)失败。
1.2.3 结果分析
- 一句话结论:median 口径看不出双缓冲的收益,min 口径才看得出来 —— 这是老问题的延续(§1.1.4 的(2)):单次 launch 的"启动 + 同步"地板是 ~19–20 μs,而 25600 个元素的 kernel 本体只有几 μs,host 抖动把中位数淹了。
| 口径 | 观察 |
|---|---|
| median | 仅 tile=1280 双缓冲更快(0.80×);3200 / 6400 反而"慢"(1.32–1.33×)——这不是 kernel 变慢,是中位数混入了偶发的慢启动(±几 μs 量级),比双缓冲的增益还大 |
| min(更接近 kernel 本体) | 小 tile 双缓冲明确受益:3200 档 19.07 → 16.04 μs(0.84×),1280 档 0.89×;大 tile 基本打平(0.99–1.01×) |
为什么受益只出现在小 tile:双缓冲的收益 = "MTE2 提前搬下一份、和当前份的计算重叠"。tile 越小 → 迭代次数越多(1280 → 20 次、3200 → 8 次、6400 → 4 次、12800 → 2 次)→ 每次搬入的建立/等待开销占比越大 → 被双缓冲藏掉的越多。等 tile 大到只剩 2–4 次迭代,kernel 本体只剩 1–2 轮、可重叠的量很小,双方都贴着 ~19–20 μs 的地板。
min 口径压下去的 3 μs 是什么:tile = 3200 时 min 从 19.07 → 16.04,正好是"每轮都等
DataCopy(i)搬完才开始计算"被省掉的时间——单缓冲时 Vector 等 MTE2、双缓冲时 MTE2 已在上一轮提前动手。反思:宿主端墙钟测量回答不了"流水有没有重叠"——median 被启动地板淹没、min 只露出冰山一角。要真正看到 MTE2 / Vector / MTE3 谁在等谁,必须上 msprof 的 timeline(§1.3)。
对应Trainium2版的问题:Trainium2版 Step 2a 问"为什么沿 free 维流式搬更多反而快"(摊薄 DMA 建立开销);但是昇腾版这里变成"为什么双缓冲在墙钟中位数里看不出快"——同样的手段(增大搬运粒度 / 双缓冲)在昇腾被 ~20 μs 的启动基线掩盖。
1.2.2 的两个边界结果都符合预期:
6 × 16384 × 2 = 196608 B正好占满 →[ OK ](min 14.510 μs,本组最优——两轮迭代、双缓冲在无 host 抖动时把流水叠满);6 × 16400 × 2 = 196800 B→ 启动前被[WARN]预判拦下、随后按预期在设备侧以aclError:507035失败。顺带第三次印证了"
GetCoreMemSize少报 256 B、但 TPipe 按物理容量分配"(16384 档的[UB]账目显示 196608 > 196352 仍通过)。
1.3 Step 2b: Learning to Use msProf(5 分)
Trainium上用 neuron-profile 的 GUI 看 timeline;昇腾侧的对应工具是 msprof op 与 MindStudio Insight(不需要 InfluxDB、不需要 SSH 端口转发,产出就是本地目录)。
cd ~/asst4-ascend/part1
python3 run_benchmark.py --kernel stream -n 25600 --tile 6400 --profile_name s2b_stream_t6400
python3 run_benchmark.py --kernel stream -n 25600 --tile 512  --profile_name s2b_stream_t512
python3 run_benchmark.py --kernel tiled  -n 25600 --tile 6400 --profile_name s2b_tiled_t6400
产出落在 part1/profile/ 下(每组一个目录)。打开方式:
- MindStudio Insight:导入
profile/s2b_stream_t6400*/目录看 timeline; - 或者直接用
msprof自带的统计输出看各项耗时。
指标口径对照(原版的 neuron-profile 指标 → 昇腾 msprof 指标)见 asst4-ascend/README.md 的 Step 2b 一节,摘录关键的几项:
| 原版观察项 | 昇腾对应观察项 |
|---|---|
dma_transfer_count |
MTE2 / MTE3 的搬运次数与搬运量 |
total_time |
算子总耗时 |
| DMA-E79 timeline | MTE2 / MTE3 的 pipeline 视图 |
| VectorE timeline | Vector 单元的 pipeline 视图 |
| (无直接对应) | MTE2 / Vector / MTE3 的三段流水重叠度(昇腾上这是显式的) |
输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel stream -n 25600 --tile 6400 --profile_name s2b_stream_t6400
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/opt/atomgit/asst4-ascend/part1/profile --application=/opt/atomgit/asst4-ascend/part1/profile/s2b_stream_t6400.sh
2026-10-09 19:00:54 [WARN]  The option "--application" will be deprecated in future version. It is recommended to specify <app> [arguments] instead.
2026-10-09 19:00:54 [INFO]  Op profiling analysis start.
2026-10-09 19:00:54 [INFO]  Running device task: DeviceProf
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 6400 元素 × 2 B × 2 缓冲 = 76800 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。
[INFO] <ProfData> Start profiling on device 0, kernel: vector_add_stream_2
[INFO] <WarmUp> Warm Up enabled. times:5
[INFO ] kernel=stream n=25600 tile=6400 blockDim=1
[INFO ] min=628.863 us  median=632.843 us  avg=634.555 us  (0.24 GB/s)
2026-10-09 19:01:00 [INFO]  Profiling running finished. All task success.
2026-10-09 19:01:00 [INFO]  Start analyze kernel on device: device0, kernel: vector_add_stream_2, name is: 0
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [PipeUtilization] success.
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [ArithmeticUtilization] success.
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [L2Cache] success.
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [Memory] success.
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [ResourceConflictRatio] success.
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [MemoryL0] success.
2026-10-09 19:01:00 [INFO]  Save profiling data with metric [MemoryUB] success.
2026-10-09 19:01:02 [INFO]  Performance Summary Report:

        1) MTE2 bandwidth utilization lower than 80% when active.
        2) MTE3 bandwidth utilization lower than 80% when active.
        3) aivector compute usage lower than 20%.

2026-10-09 19:01:02 [INFO]  Operator Basic Information:

        Op Name: vector_add_stream_2
        Op Type: vector
        Task Duration(us): 7.340293
        Block Dim: 1
        Mix Block Dim:
        Device Id: 0
        Pid: 5239
        Current Freq: 1650
        Rated Freq: 1650

2026-10-09 19:01:02 [INFO]  Profiling results saved in /opt/atomgit/asst4-ascend/part1/profile/OPPROF_20261009190054_AWSXYMXLTSZJJYRP
2026-10-09 19:01:02 [INFO]  Profiling data parse finished.
2026-10-09 19:01:02 [INFO]  Op profiling finish. Welcome to next use.
[INFO ] 本次剖析产出:/opt/atomgit/asst4-ascend/part1/profile/s2b_stream_t6400(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 6400 元素 × 2 B × 2 缓冲 = 76800 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 25600
tile        : 6400 个元素  (单次搬运 12800 B)
block-dim   : 1 个 AI Core
latency     : median 26.750 us   min 24.841 us   avg 28.189 us
bandwidth   : 5.74 GB/s  (按访存量 153600 B = 0.146 MiB 估算)

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel stream -n 25600 --tile 512  --profile_name s2b_stream_t512
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/opt/atomgit/asst4-ascend/part1/profile --application=/opt/atomgit/asst4-ascend/part1/profile/s2b_stream_t512.sh
2026-10-09 19:01:08 [WARN]  The option "--application" will be deprecated in future version. It is recommended to specify <app> [arguments] instead.
2026-10-09 19:01:08 [INFO]  Op profiling analysis start.
2026-10-09 19:01:08 [INFO]  Running device task: DeviceProf
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 512 元素 × 2 B × 2 缓冲 = 6144 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。
[INFO] <ProfData> Start profiling on device 0, kernel: vector_add_stream_2
[INFO] <WarmUp> Warm Up enabled. times:5
[INFO ] kernel=stream n=25600 tile=512 blockDim=1
[INFO ] min=637.123 us  median=641.253 us  avg=643.298 us  (0.24 GB/s)
2026-10-09 19:01:14 [INFO]  Profiling running finished. All task success.
2026-10-09 19:01:14 [INFO]  Start analyze kernel on device: device0, kernel: vector_add_stream_2, name is: 0
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [PipeUtilization] success.
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [ArithmeticUtilization] success.
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [L2Cache] success.
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [Memory] success.
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [ResourceConflictRatio] success.
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [MemoryL0] success.
2026-10-09 19:01:14 [INFO]  Save profiling data with metric [MemoryUB] success.
2026-10-09 19:01:15 [INFO]  Performance Summary Report:

        1) MTE2 bandwidth utilization lower than 80% when active.
        2) MTE3 bandwidth utilization lower than 80% when active.
        3) aivector compute usage lower than 20%.

2026-10-09 19:01:15 [INFO]  Operator Basic Information:

        Op Name: vector_add_stream_2
        Op Type: vector
        Task Duration(us): 15.100604
        Block Dim: 1
        Mix Block Dim:
        Device Id: 0
        Pid: 5313
        Current Freq: 1650
        Rated Freq: 1650

2026-10-09 19:01:15 [INFO]  Profiling results saved in /opt/atomgit/asst4-ascend/part1/profile/OPPROF_20261009190108_DGQJBUHSUQMXOYWM
2026-10-09 19:01:16 [INFO]  Profiling data parse finished.
2026-10-09 19:01:16 [INFO]  Op profiling finish. Welcome to next use.
[INFO ] 本次剖析产出:/opt/atomgit/asst4-ascend/part1/profile/s2b_stream_t512(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 512 元素 × 2 B × 2 缓冲 = 6144 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : stream  (可执行文件里的入口: stream)
n           : 25600
tile        : 512 个元素  (单次搬运 1024 B)
block-dim   : 1 个 AI Core
latency     : median 33.730 us   min 24.310 us   avg 34.637 us
bandwidth   : 4.55 GB/s  (按访存量 153600 B = 0.146 MiB 估算)

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel tiled  -n 25600 --tile 6400 --profile_name s2b_tiled_t6400
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/opt/atomgit/asst4-ascend/part1/profile --application=/opt/atomgit/asst4-ascend/part1/profile/s2b_tiled_t6400.sh
2026-10-09 19:01:21 [WARN]  The option "--application" will be deprecated in future version. It is recommended to specify <app> [arguments] instead.
2026-10-09 19:01:21 [INFO]  Op profiling analysis start.
2026-10-09 19:01:21 [INFO]  Running device task: DeviceProf
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 6400 元素 × 2 B × 1 缓冲 = 38400 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。
[INFO] <ProfData> Start profiling on device 0, kernel: vector_add_single_1
[INFO] <WarmUp> Warm Up enabled. times:5
[INFO ] kernel=single n=25600 tile=6400 blockDim=1
[INFO ] min=627.293 us  median=631.763 us  avg=633.088 us  (0.24 GB/s)
2026-10-09 19:01:26 [INFO]  Profiling running finished. All task success.
2026-10-09 19:01:26 [INFO]  Start analyze kernel on device: device0, kernel: vector_add_single_1, name is: 0
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [PipeUtilization] success.
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [ArithmeticUtilization] success.
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [L2Cache] success.
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [Memory] success.
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [ResourceConflictRatio] success.
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [MemoryL0] success.
2026-10-09 19:01:26 [INFO]  Save profiling data with metric [MemoryUB] success.
2026-10-09 19:01:28 [INFO]  Performance Summary Report:

        1) MTE2 bandwidth utilization lower than 80% when active.
        2) MTE3 bandwidth utilization lower than 80% when active.
        3) aivector compute usage lower than 20%.

2026-10-09 19:01:28 [INFO]  Operator Basic Information:

        Op Name: vector_add_single_1
        Op Type: vector
        Task Duration(us): 8.740350
        Block Dim: 1
        Mix Block Dim:
        Device Id: 0
        Pid: 5386
        Current Freq: 1650
        Rated Freq: 1650

2026-10-09 19:01:28 [INFO]  Profiling results saved in /opt/atomgit/asst4-ascend/part1/profile/OPPROF_20261009190121_OEONOOMWNBUAYEDI
2026-10-09 19:01:28 [INFO]  Profiling data parse finished.
2026-10-09 19:01:28 [INFO]  Op profiling finish. Welcome to next use.
[INFO ] 本次剖析产出:/opt/atomgit/asst4-ascend/part1/profile/s2b_tiled_t6400(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] kernel 本次要分配:3 张量 × 6400 元素 × 2 B × 1 缓冲 = 38400 B  → 在 GetCoreMemSize 报的可用量之内
[UB] 未声明预留(--reserve none)。加 --reserve 8k 可做预留实验。

kernel      : tiled  (可执行文件里的入口: single)
n           : 25600
tile        : 6400 个元素  (单次搬运 12800 B)
block-dim   : 1 个 AI Core
latency     : median 24.950 us   min 18.010 us   avg 25.206 us
bandwidth   : 6.16 GB/s  (按访存量 153600 B = 0.146 MiB 估算)
msprof op 输出的各 CSV 字段速览
表头为本机 CANN 实测;字段语义依据:
op_summary(算子详细信息)里的 Task Duration 定义、l2_cache命中率文档,以及 MTE/Vector/Scalar 引擎的基准语义。
OpBasicInfo.csv —— 算子基础信息
Op Name:被采集的算子入口名(本作业:vector_add_stream_2/matrix_transpose_0)Op Type:算子类别(本作业为vector;矩阵类为cube)Task Duration(us):该算子一次执行的设备侧总耗时(官方文档:可按其排序找出高耗时算子)Block Dim:本次启动的块数(--block-dim)Mix Block Dim/Device Id/Pid:混合块维 / 设备号 / 进程号Current Freq/Rated Freq:采集时实际核频 / 额定核频(本机 1650/1650 —— 换算[AICoreMemoryRates]的 Byte/cycle 用)
PipeUtilization.csv —— 流水(引擎)占用
block_id/sub_block_id:块号 / 子块号(多核时每个 block 一行)aiv_time(us)/aiv_total_cycles:该块 AIV 侧(向量核)总耗时 / 总周期;aiv_*的所有占比都以它为分母aiv_vec_time/aiv_vec_ratio:Vector 计算占用 μs / 占比(转置只有 ~2.5%)aiv_scalar_time/aiv_scalar_ratio:标量(指令发射、地址/同步等)占用 / 占比(转置 96.6%→83.5%,全报告的主角)aiv_mte2_time/aiv_mte2_ratio/aiv_mte2_active_bw(GB/s):MTE2(GM→UB 数据搬入)占用 / 占比 / 有效带宽aiv_mte3_time/aiv_mte3_ratio/aiv_mte3_active_bw(GB/s):MTE3(UB→GM 数据搬出)同上aic_*:Cube(AIC)侧对应项(纯 Vector 算子为 NA)aiv_icache_miss_rate:指令缓存缺失率
ResourceConflictRatio.csv —— 资源/访存冲突占比
aiv_vec_total_cflt_ratio:Vector 访存总冲突占比aiv_vec_bankgroup_cflt_ratio:bank group 冲突(同一迭代 8 块挤进同组)aiv_vec_bank_cflt_ratio:严格同 bank 冲突(Part 0 强调的那种)aiv_vec_resc_cflt_ratio/aiv_vec_mte_cflt_ratio:资源冲突 / 与 MTE 引擎的冲突aiv_vec_wait_ratio:Vector 等待占比(等数据/同步;≠ bank 冲突)aiv_mte2_wait_ratio/aiv_mte3_wait_ratio:搬入 / 搬出引擎的等待占比
Memory.csv —— 搬运与主存带宽
aiv_gm_to_ub_bw/aiv_ub_to_gm_bw(GB/s):MTE2 搬入 / MTE3 搬出的有效带宽aiv_main_mem_read_bw/aiv_main_mem_write_bw(GB/s):对 HBM 的读写带宽aic_l1_read_bw/aic_l1_write_bw(GB/s):Cube 侧 L1 带宽(纯 Vector 为 NA)aiv_mte2_instructions/aiv_mte3_instructions:搬运指令条数(本作业转置 = 1048576 / 1048576)read_main_memory_datas/write_main_memory_datas(KB):实际读写主存总量(转置单核 ≈ 4× 实数据:32 B 粒度 × 128 B 行)GM_to_UB_bw_usage_rate/UB_to_GM_bw_usage_rate(%):搬入 / 搬出带宽利用率(据此可反推 msprof 参考带宽 ≈ 195 GB/s,见 README)
MemoryUB.csv / MemoryL0.csv —— UB 与 L0 读写带宽
aiv_ub_read_bw_vector/aiv_ub_write_bw_vector(GB/s):Vector 读写 UB 的带宽(t512 实测 6.6 / 3.3 GB/s)aic_l0a/l0b/l0c_*(MemoryL0.csv):Cube 侧 L0A/L0B/L0C 带宽(纯 Vector 为 NA)
ArithmeticUtilization.csv —— 计算利用率
aiv_vec_ratio:Vector 计算占比(与 PipeUtilization 的 vec 一致)aiv_vec_fp16_ratio / *_int32_ratio等:各精度指令占比aiv_vec_fops:Vector 执行的 fops(指令宽度口径:小 tile 时掩码浪费会被算进去,跨 tile 比较 AI 要小心——§1.3b 的 t16 即此例)aic_cube_*:Cube 侧(转置为 NA)
L2Cache.csv —— L2 命中率
aiv_write_hit_rate/aiv_read_hit_rate/aiv_total_hit_rate(%):写 / 读 / 总命中率(本作业 ~94–97%)aiv_r0/r1_read_cache_hit/_miss_allocate等:命中与未命中(含上行/归并)计数
主要关心指标
| 想回答 | 看哪个文件 | 本作业实测 |
|---|---|---|
| 核函数总耗时(原问 1) | OpBasicInfo.csv 的 Task Duration |
15.10 / 7.34 / 8.74 μs |
| 搬运指令数(原问 1) | ≈ 3 × 迭代数 | 150 / 12 / 12 |
| 为什么大 chunk 快(原问 2) | PipeUtilization.csv 的 scalar / vec / mte2 / mte3 |
scalar 95.2% vs 36.1% |
| 重叠区间(原问 3) | 同上 + ResourceConflictRatio.csv |
ratio 和 2.29 vs 1.15 |
| memory-bound 判断 | Memory*.csv(UB 带宽)+ ArithmeticUtilization.csv |
UB 读/写 6.6 / 3.3 GB/s,未饱和 |
| Cache 复用 | L2Cache.csv |
命中率 ≈ 1.7%(流式,无复用) |
| bank 冲突率 | ResourceConflictRatio.csv |
t512 的 vec-bank 冲突 0.000 |
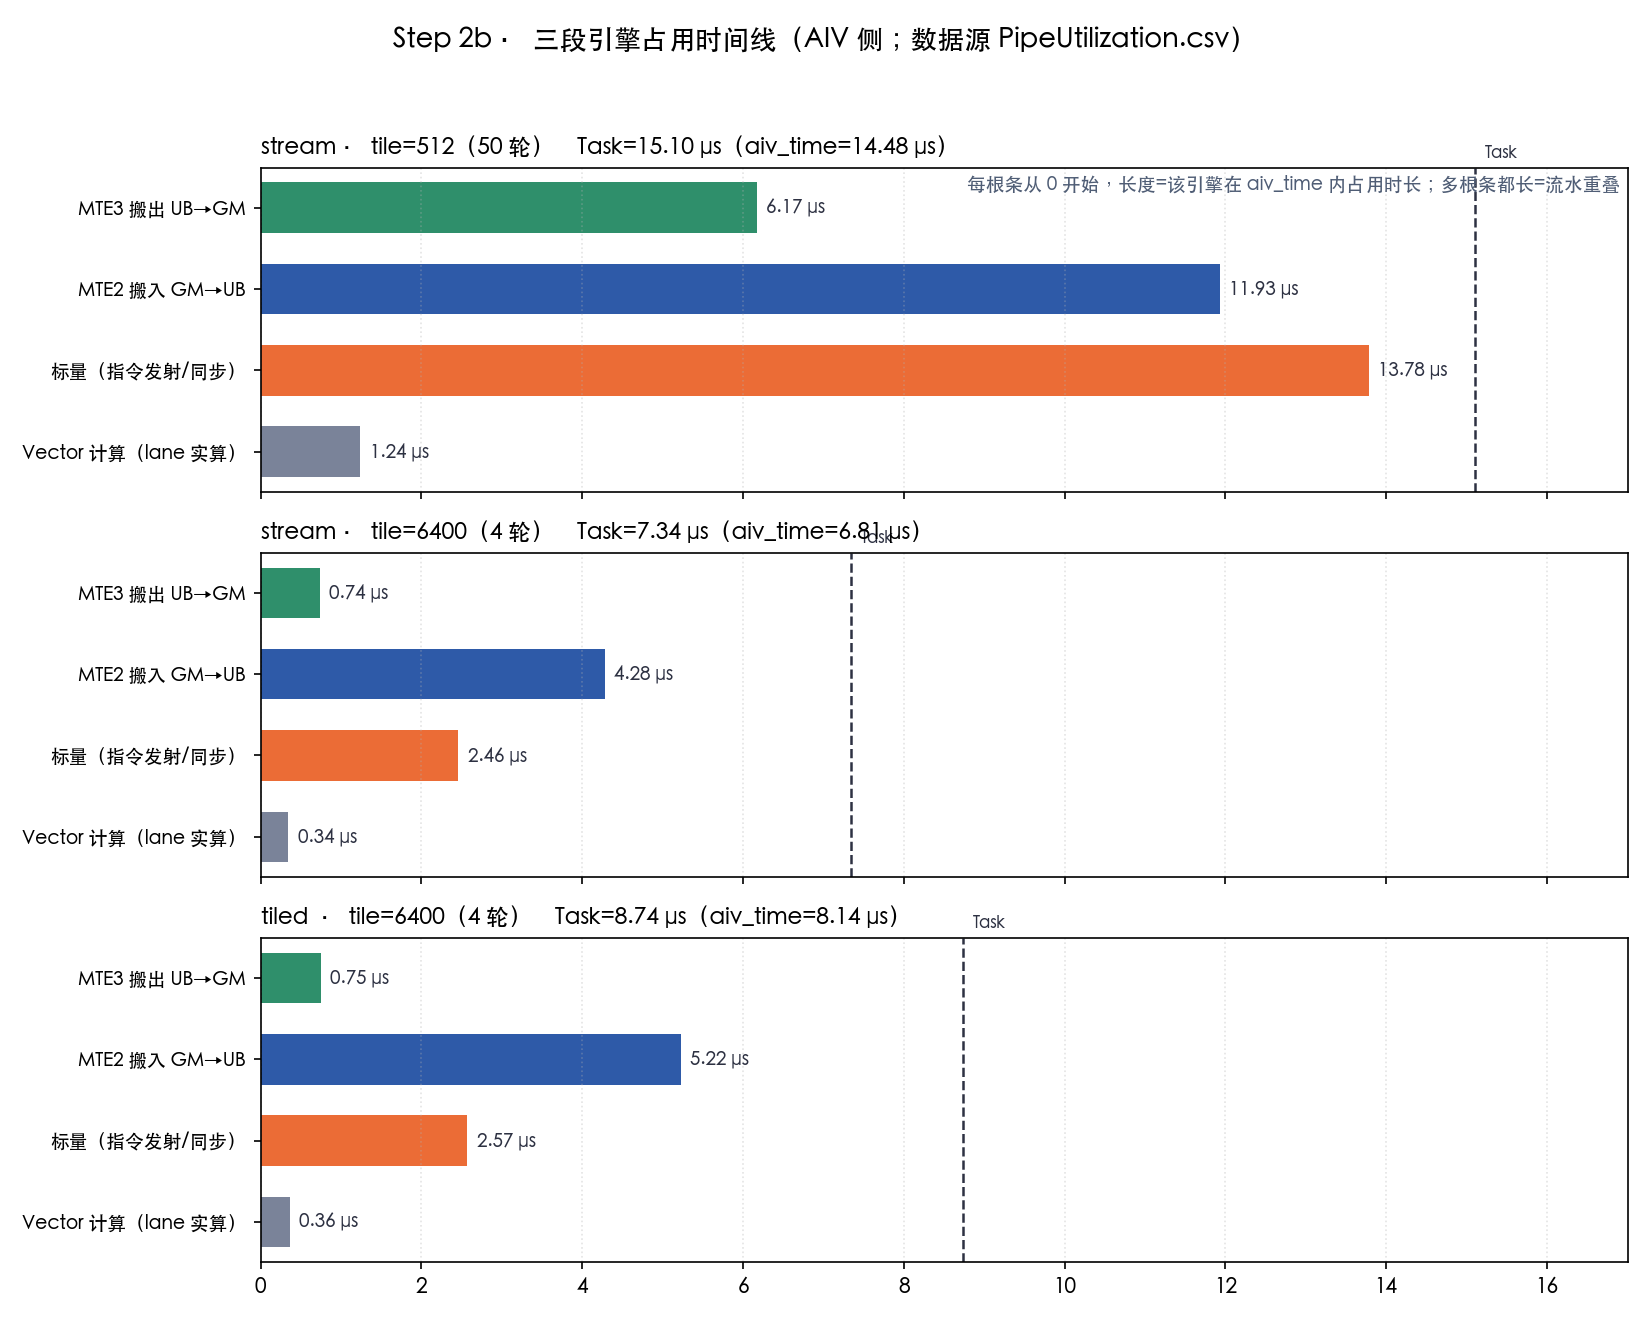
上图把三组各自的四根竖排横条叠在一起看:t512 的"标量"条几乎顶到 Task(95%),而 t6400 的两组四面都短——重叠存在(条长之和远超 Task),但 t512 的重叠全都挤在指令发射与同步的等待里。这也是用 CSV 直接画的"timeline"(无需 MindStudio Insight)。
Insight Details 页的数字,CSV 里已经有了:L2 总命中率 1.73%(每个元素只读一遍、纯流式);UB 读 / 写带宽 6.6 / 3.3 GB/s;Vector 计算占比 8.6%(fp16 4.2%)、总 fops 32128。Roofline 判定:既不是计算瓶颈(vec 占比 8.6%),也不是内存带宽瓶颈(UB/L2 利用率均为个位数 GB/s),而是指令 / 标量开销瓶颈(scalar 95%)——Insight Details 的热力图结论与此一致。
可以对比platform_config/<SoC>.ini里的数据:
atomgit@6ac4a72a17ae8e63171149c9:~$ grep -inE "bw|bandwidth|rate|pll" $ASCEND_HOME_PATH/aarch64-linux/data/platform_config/Ascend910B4.ini

[AICoreMemoryRates]
ddr_rate=32          ddr_read_rate=32    ddr_write_rate=32    // HBM(读/写同 32 B/cycle)
l2_rate=110          l2_read_rate=110    l2_write_rate=86     // L2
l1_to_l0_a_rate=512  l1_to_l0_b_rate=256 l1_to_ub_rate=128    // L1 → 各计算缓冲
l0_c_to_ub_rate=256  ub_to_l2_rate=64    ub_to_ddr_rate=64    // 回写路径
ub_to_l1_rate=128
换算成 GB/s:Byte/cycle × 实际时钟。核频 1650 MHz 取自 OpBasicInfo.csv 的 Current Freq / Rated Freq 两列(dump/op_basic_info.txt 同值,见 §1.3 三组输出)。以它计:
- HBM ≈ 32 × 1.65 ≈ 53 GB/s、L2 ≈ 110 × 1.65 ≈ 182 GB/s;
- 用 1.8 GHz 计 L2 ≈ 198 GB/s
对比Memory.csv 的 GM_to_UB_bw_usage_rate(%) / UB_to_GM_bw_usage_rate(%) 是 msprof 按某个参考带宽算的利用率。用"实测带宽 ÷ 利用率"可反推参考值:
GM→UB:6.59 GB/s ÷ 3.38% ≈ 195 GB/s
UB→GM:3.29 GB/s ÷ 1.87% ≈ 176 GB/s
~195 GB/s,同量级,基本可以认为 msprof 的参考就是 L2 通路这条 rate。
三问回答
(数据来自 PipeUtilization.csv,aiv_* 是 AIV 侧时间轴上的占用;ratio = 该项 / aiv_time):
问1:大 tile 与小 tile 的搬运次数与总耗时
| 组 | 迭代次数 | 搬运指令数(≈ 3×迭代) | Task(μs) | aiv_time(μs) |
|---|---|---|---|---|
| stream t512 | 50 | ~150 | 15.10 | 14.478 |
| stream t6400 | 4 | ~12 | 7.34 | 6.809 |
| tiled t6400 | 4 | ~12 | 8.74 | 8.136 |
总字节不变(153600 B),小 tile 的搬运指令数多 12.5 倍,Task 耗时也大一倍——"次数多"与"慢"是同一个原因的两面。
问2:总结耗时与搬运次数的关系
搬运次数多的时候慢——主要不是搬得慢,是建立与同步开销(scalar)
| 组 | aiv_vec | aiv_scalar | aiv_mte2(有效带宽) | aiv_mte3(有效带宽) |
|---|---|---|---|---|
| stream t512 | 1.24 μs (8.6%) | 13.78 μs (95.2%) | 11.93 (82.4%, 8.0 GB/s) | 6.17 (42.6%, 7.7 GB/s) |
| stream t6400 | 0.34 (5.0%) | 2.46 (36.1%) | 4.28 (62.8%, 22.3 GB/s) | 0.74 (10.8%, 64.7 GB/s) |
t512 的 Vector 实际只有 8.6% 占用,标量单元却占了 95.2%——几百条 32 B 级小搬运,每条都要过一遍标量单元的指令发射与 WaitFlag 同步(ResourceConflictRatio.csv 里 aiv_vec_wait_ratio = 0.768,Vector 四分之三的时间在等)。大 tile 把指令数压到 1/12.5,标量占用降到 36%,MTE2/MTE3 有效带宽升到 22.3 / 64.7 GB/s。时间花在"每次搬运的建立+同步",不在搬字节本身。
Trainium侧 "FREE_DIM = 1000 比 2000 快" 的对照 —— 不矛盾,是同一机制的两个区间:
Trainium FREE_DIM = 1000 比 2000 快的答案(Hint: pipelining)其实写在题面自己的引言里(asst4-trainium2/README.md 的 Step 2a):
"Too large of a tile size often leads to inefficient pipelining between engines and high memory pressure in SBUF in cases of data reuse"
Trainium 侧并没有昇腾那样的显式"双缓冲"API(没有 InitBuffer(que, num=2) 这类 buffer 份数参数)—— 重叠来自引擎级并发 + 编译器流水:每个 NeuronCore 有 16 个 DMA 引擎可与计算引擎并行,NKI 的 dma_move 是异步的,编译器在循环迭代之间把"下一份的搬运"与"当前份的计算"重叠。而重叠的前提是 SBUF 能同时驻留"正在算的一份"和"正在搬的下一份"(隐式双缓冲 staging)。FREE_DIM=2000 时每个 (128, 2000) tile 占用过大,两份放不下 → memory pressure → 编译器无法重叠 → 搬运与计算串行;FREE_DIM=1000 的两份放得下 → 流水成立 → 尽管 DMA setup 次数更多(每次 setup 有固定开销),总时间反而更短。
昇腾这次的数据同时落到了两个区间:
| 档位 | 现象 | 机制 |
|---|---|---|
| t512(50 次搬运) | 15.10 μs,最慢 | 跌入"单笔搬运的固定开销支配"区间:scalar 95.2%、vec 仅 8.6%、MTE 带宽 8 GB/s——不是"次数多"让它慢,是每笔 32 B 级搬运的指令发射 + WaitFlag 同步 |
| t1280(20 次搬运) | 双缓冲 22.5 μs(min 19.5)< 单缓冲 27.9 μs(min 21.8) | 与 Trainium 问题同构:同样的 20 次搬运,让它们在途化(双缓冲)后更快——搬运被流水藏住了 |
所以结论统一为一句:搬运次数本身不是性能指标;决定快慢的是"每笔搬运的固定开销能否被流水(重叠)藏住"。Trainium 的 1000-vs-2000 落在"藏得住"一侧(SBUF 容得下两代数据、流水能建立);昇腾的 512 落在"藏不住、还叠加建立开销"一侧;而昇腾 t1280 档的双缓冲对照,正是原版那个问题在昇腾上的直接体现。
三段重叠的证据(ratio 之和 > 1)
| 组 | vec+scalar+mte2+mte3 的 ratio 之和 | 说明 |
|---|---|---|
| stream t512 | 0.086 + 0.952 + 0.824 + 0.426 ≈ 2.29 | 重叠存在(>1 即并行的证据),但都被标量/慢搬运占了 |
| stream t6400 | 0.050 + 0.361 + 0.628 + 0.108 ≈ 1.15 | 同样重叠,效率高得多 |
如果三段严格串行,ratio 之和最多 = 1;两组的和都 > 1,证明 MTE2 / MTE3 / Vector 确实在同一段时间内并行。双缓冲与单缓冲(stream vs tiled @ 6400)的差别也在此现形:7.34 vs 8.74 μs(-16%),MTE2 有效带宽 22.3 vs 18.3 GB/s——墙钟中位数看不到(§1.2.3),剖析数据里一目了然。
问3:UB 资源冲突占比(bank 冲突)
三组的 ResourceConflictRatio.csv(aiv_vec_* 为 Vector 访存冲突占比):
| 组 | 总冲突 | bankgroup 冲突 | bank 冲突 | 资源冲突 | MTE 冲突 | vec 等待 |
|---|---|---|---|---|---|---|
| stream t512 | 0.8% | 0.8% | 0.000 | 0 | 0 | 76.8% |
| stream t6400 | 2.0% | 1.9% | 0.12% | 0 | 0 | 70.8% |
| tiled t6400 | 1.7% | 1.7% | 0.18% | 0 | 0 | 73.7% |
结论:tileLength 与 LocalTensor 分配方式没有引入额外 bank 冲突——最严苛的"同 bank 冲突"(Part 0 说的"8 个 DataBlock 全落同一 bank group"那种)只有 0–0.18%,总冲突 ≤ 2%。原因:我们的 x / y / z 是连续分配的,DataCopy 用 count 形式(连续搬运),Add 用 blkStride = 1(迭代内 8 个 DataBlock 顺序落在交错的 bank 上)——恰好避开 Part 0 例子里"跳读(srcBlkStride = 16)+ 连续写"与"同组写"那两类坑。那 1–2% 的 bankgroup 级冲突来自三个张量同时活跃时偶发的读-读/写-写重叠,量级上可忽略。
顺带澄清:表中 70–77% 的 vec 等待 ≠ bank 冲突——那是 Vector 在等 MTE 搬完数据 / 同步(§1.3 三问 2 里"scalar 95%、vec 只占 8.6%"的另一面),ResourceConflictRatio 里它单独一列,和 bank 冲突是两回事。
1.3b Roofline:tileLength 扫描(补充实验)
用 msprof op 对 9 组 tile(tiled×7 + stream×2)逐一采集,每档提取 Task Duration、aiv_vec_fops、read/write_main_memory_datas,得到 Roofline 图(横轴 AI = FLOP/B,纵轴实现吞吐;内存斜率按 msprof 参考带宽 195 GB/s,计算天花板按 vector 128 lane × 核频(OpBasicInfo.csv 的 Current Freq = 1650 MHz)≈ 211 GFLOP/s):
之前测算的memory bound = 195 GB/s(内存斜率):
6.59 GB/s ÷ 3.38% ≈ 195 GB/s ← msprof 内部参考口径(推断)
再估算一下算数强度:211 GFLOP/s(计算横线)
211 = 128 lane × 1.65 GHz
三个假设叠加:① vector 单元每次迭代 128 条 lane(fp16 的 mask ≤ 128);② 每 lane 每周期 1 次运算(没算 FMA 双发、没算流水效率);③ 频率取 OpBasicInfo.csv 的 1650 MHz。
没有任何一个是已测或已公布的数字——这是图上最不确定的一条线。
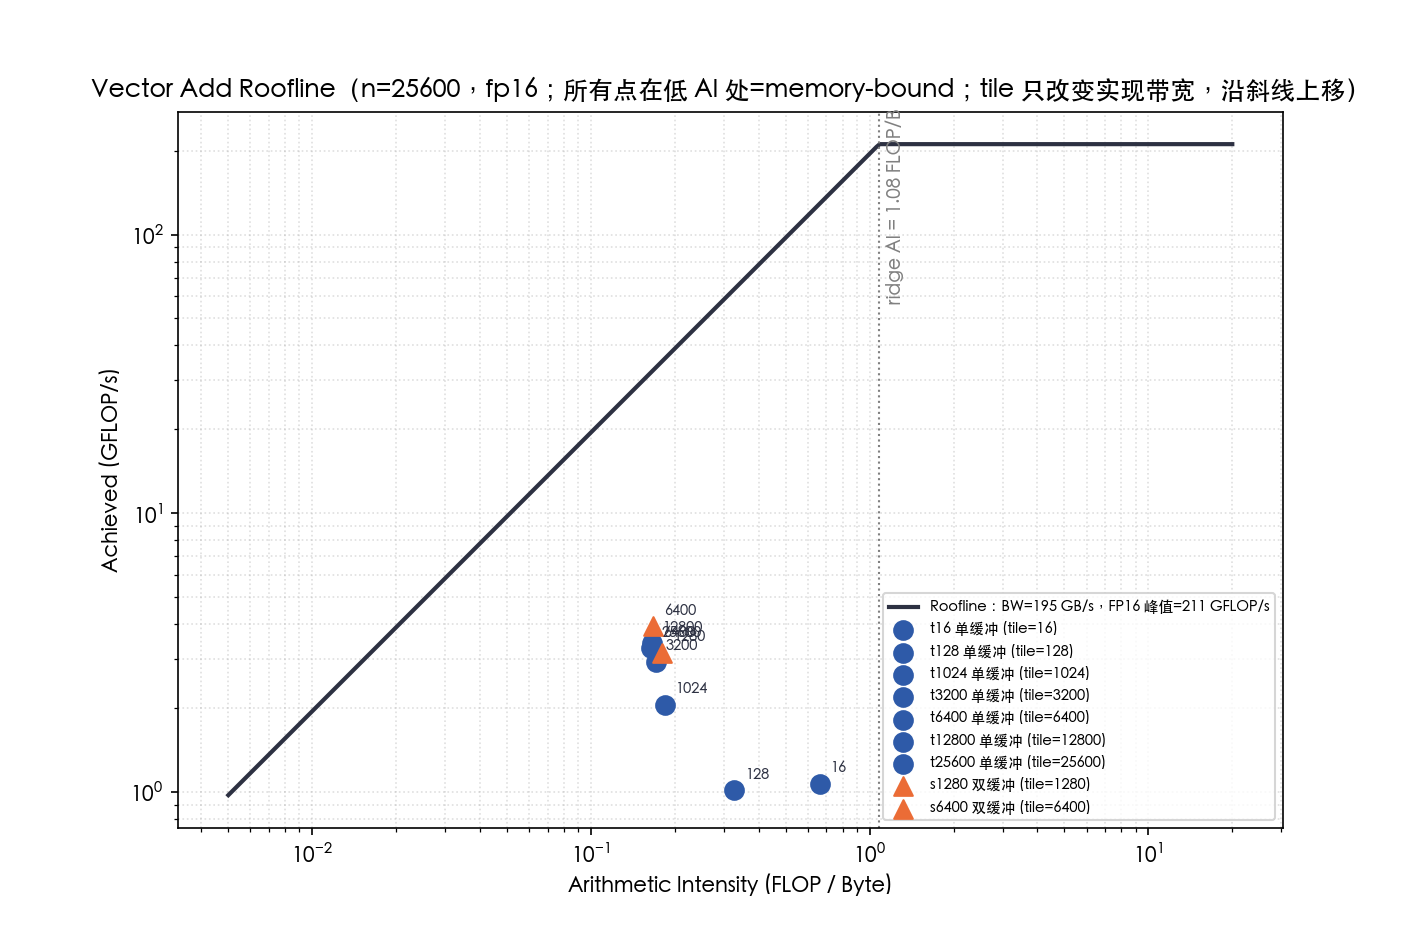
label   kernel tile      task_us     GFLOP/s     GB/s      AI(FLOP/B)
t16     tiled     16    382.160     1.072      1.617     0.663   ← 见注
t128    tiled    128     50.420      1.018      3.115     0.327
t1024   tiled   1024     14.040      2.060     11.177     0.184
t3200   tiled   3200      9.100      2.940     17.245     0.171
t6400   tiled   6400      7.980      3.288     19.665     0.167
t12800  tiled  12800      7.580      3.428     20.703     0.166
t25600  tiled  25600      7.880      3.281     19.931     0.165
s1280   stream 1280       8.940      3.164     17.553     0.180
s6400   stream 6400       6.680      3.928     23.473     0.167
四条结论:
- AI 几乎不随 tile 变(t128 以上收敛到 0.165–0.18 FLOP/B),且全部远低于 ridge(211 ÷ 195 ≈ 1.08)→ 全员 memory-bound。AI 是 kernel 的结构属性(fp16 加法,按 profiler 的 fops 口径),tile 改不动它。
- tile 增大 = 点沿 memory-bound 斜线上移:实现带宽 3.1 → 20.7 GB/s(t12800 最优),GFLOP/s 1.0 → 3.4;耗时 50.4 → 7.6 μs 的地板。这正是"摊薄固定开销"在 Roofline 上的形态:x 不动,y 沿斜线爬。
- stream(双缓冲)同 tile 高一档:s6400 6.68 μs / 23.47 GB/s vs t6400 7.98 / 19.67——双缓冲把实现带宽再抬 ≈19%,又一次在剖析数据里确认 §1.2.3 的结论。
- 绝对带宽仍远低于 195 GB/s 参考(最高 23.5 ≈ 12%):Roofline 展示的不是"带宽打满",而是"每次搬运的建立/同步开销(scalar)拖住了实现带宽"——单核、footprint 0.15 MB 远小于 L2 的流式小算子就是这种形态。
注:t16 一行的 bytes ≈ 4× 正常值、task 382 μs——profiler 对小 tile 的多次 launch 与"按指令宽度(128 lane)计 fops"叠加了口径偏差,仅作"小 tile 极端"参考,不计入主趋势。
图的两个峰值是
--bw-gbps 195 --peak-gflops 211的可调参数(910B4 无官方逐级公开值);峰值改动不影响点的相对位置与"全员 memory-bound"的结论。
1.4 Step 3: Matrix Transpose(15 分 = 10 编码 + 5 写作 (+ 1 EC))
1.4.1 实现说明
Vector计算单元每个迭代会从UB中取出 8个DataBlock,每个DataBlock数据块内部地址连续,长度 32 Byte,以 half(2B)作为元素类型:一个 DataBlock 装 16 个元素,一次 repeat 处理 128 个。
kernels.cpp 里的 KernelTranspose 是一个基准实现,按 16×16 分块逐块做「搬入 → 转置 → 搬出」:
多核切分:按块列 bj 轮转分给各核(bj = blockIdx; bj < blocksN; bj += blockNum),这样不要求块列数能被核数整除。
- 搬入:16 行各 32 B,用 连续搬运形式的
DataCopy逐行搬(首地址 32 B 对齐、长度正好一个 DataBlock);逐行 32 B 搬运的地址算术最直白、不必先算 gap 与对齐,所以基准版这么写; - 转置:
AscendC::Transpose(dst, src)—— 该接口的粒度就是 16×16(m、n都必须是 16 的整数倍,Host 侧已校验); - 搬出:转置结果同样按 16 行各 32 B 写回
out的对应位置。
分块内的索引映射:
块级上 (行块 bi, 列块 bj) → (行块 bj, 列块 bi),块内 (r, c) → (c, r)——两次行列互换刚好合成一次转置,*n 与 *m 的差别正是"输入行宽"与"输出行宽"的互换。
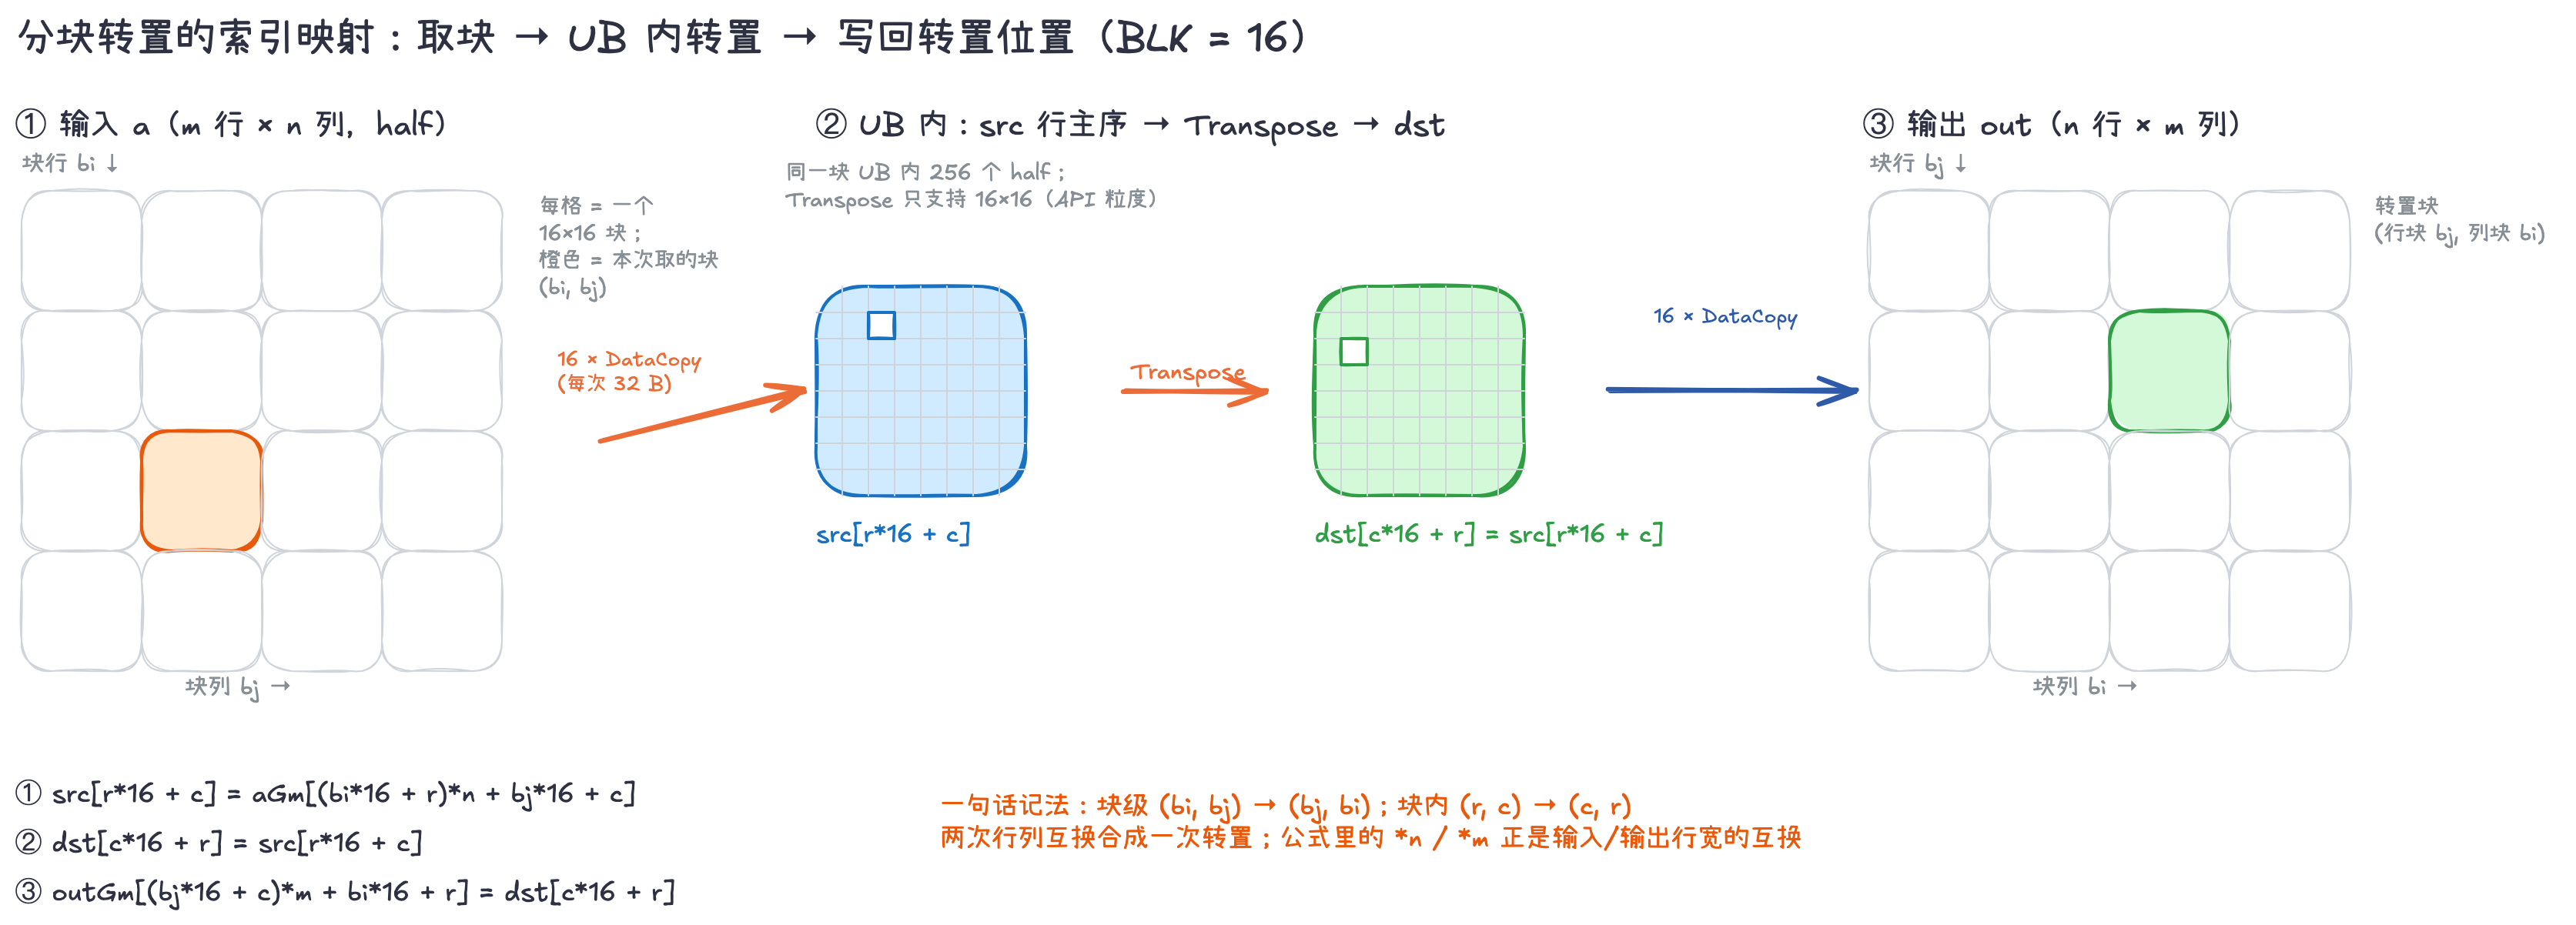
设输入块的行、列起点分别为 bi*16、bj*16(bi = 行块索引、bj = 列块索引),块内坐标记为 (r, c) ∈ [0,16)²:
| 步骤 | 索引关系 | 说明 |
|---|---|---|
| ① 搬入 | src[r*16 + c] = aGm[(bi*16 + r)*n + bj*16 + c] |
循环 16 次、每次搬该块一整行(16 个 half = 32 B = 1 个 DataBlock)。搬完后 src 在 UB 里是行主序的 16×16:第 r 行连续放 16 个元素,即 src[r*16 + c]。源地址里的 *n 是输入矩阵的行宽(跨行要跳过 n 个元素) |
| ② Transpose | dst[c*16 + r] = src[r*16 + c] |
把 16×16 就地转置(API 粒度所限,只能 16×16)。dst 同样行主序,但行列互换:dst 的第 c 行 = src 的第 c 列 |
| ③ 搬出 | outGm[(bj*16 + c)*m + bi*16 + r] = dst[c*16 + r] |
dst 的第 c 行(16 个连续 half)写到 out 的第 (bj*16 + c) 行、从第 bi*16 列开始。这里的 *m 是输出矩阵的行宽(out 的形状是 n×m,所以行宽从 n 变成 m) |
当前实现要求 输入矩阵大小 m、n 都是 16 的整数倍:
Transpose(dst, src)官方规定粒度就是 16×16(A2/A3 只支持 16×16 的uint16_t/half/int16_t转置)- 输入行首地址
aGm[(bi*16 + r) * n + bj*16]元素偏移必须 16 的倍数(= 32 B 对齐)。bj*16✓、(bi*16+r)*16✓,但×(n)要能被 16 整除 ⇒ n 必须是 16 的倍数 - 输出行首地址
outGm[(bj*16 + c) * m + bi*16]同理 ⇒ m 必须是 16 的倍数。
如果要支持任意尺寸:
| 方案 | 做法 | 代价 |
|---|---|---|
| A. Host 侧补齐(最省事) | 把输入拷进 padded 缓冲(补 0 到 16 的倍数),转置后再裁回 | 多一次 host 拷贝,kernel 一行不改 |
| B. kernel 内处理尾块 | 搬入用 DataCopyPad(按字节、支持非对齐);但 Transpose 只吃完整 16×16 → 尾块补 0 成 16×16 再转,写回时只写有效行/列 |
复杂,且要处理行跨步(blkStride 单位是 32 B) |
| C. 尾块标量逐元素 | 正确但极慢,只适合极小尾块 | 性能灾难 |
DataCopy 函数入参:
- 连续搬运(最常用)
// GM -> UB
template <typename T> __aicore__ inline void
DataCopy(const LocalTensor<T>&  dst, const GlobalTensor<T>& src, const uint32_t count);

// UB -> GM
template <typename T> __aicore__ inline void
DataCopy(const GlobalTensor<T>& dst, const LocalTensor<T>&  src, const uint32_t count);

// Local -> Local
template <typename T> __aicore__ inline void
DataCopy(const LocalTensor<T>&  dst, const LocalTensor<T>&  src, const uint32_t count);
- 非连续搬运(带 DataCopyParams)
template <typename T> __aicore__ inline void
DataCopy(const LocalTensor<T>&  dst, const GlobalTensor<T>& src, const DataCopyParams& repeatParams);

template <typename T> __aicore__ inline void
DataCopy(const GlobalTensor<T>& dst, const LocalTensor<T>&  src, const DataCopyParams& repeatParams);

template <typename T> __aicore__ inline void
DataCopy(const LocalTensor<T>&  dst, const LocalTensor<T>&  src, const DataCopyParams& repeatParams);
「一次搬多行」正是 EC 的优化方向(见 §1.4.4 第 1 条,可把每块 32 次调用降到 2 次)。
DataCopyParams 结构体:
struct DataCopyParams {
    uint16_t blockCount = 1;                    // DEFAULT_DATA_COPY_NBURST
    uint16_t blockLen   = 0;
    union { uint16_t srcGap = 0; uint16_t srcStride; };   // 同一内存,两个名字
    union { uint16_t dstGap = 0; uint16_t dstStride; };
};
| 字段 | 类型 | 含义 | 单位 | 取值范围 |
|---|---|---|---|---|
blockCount |
uint16_t |
连续传输数据块的个数 | 块 | [1, 4095](9.0 部分通路 [0, 4095],0 = NOP) |
blockLen |
uint16_t |
每个连续传输数据块的长度 | DataBlock (32 B) | [0, 65535](0 = NOP) |
srcGap / srcStride |
uint16_t |
源操作数相邻块的间隔(前块尾 → 后块头) | DataBlock (32 B) | [0, 65535] |
dstGap / dstStride |
uint16_t |
目的操作数相邻块的间隔(前块尾 → 后块头) | DataBlock (32 B) | [0, 65535] |
示例场景:GM 上 [128, 256] 的 half 矩阵,取前 64 行、每行 128 个元素,搬到 UB 连续存放。
AscendC::DataCopyParams params;
params.blockCount = 64;                            // 搬 64 行 → 64 轮
params.blockLen   = 128 * sizeof(half) / 32;       // 每行 256B = 8 个 DB
params.srcGap     = (256 - 128) * sizeof(half)/32; // 源行末要跳过 128 个 half = 8 个 DB
params.dstGap     = 0;                             // UB 里连续存放,无缝
AscendC::DataCopy(ubLocal, srcGm[0], params);
src (GM, 每行 256 half = 16 DB):
行0: [取前8个DB | 跳过8个DB]
行1: [取前8个DB | 跳过8个DB]     ← blockCount=64 轮,每轮跨 8+8=16 个 DB
...

dst (UB):
[行0前128个][行1前128个]...  ← dstGap=0,紧密排列,共 64×8 = 512 个 DB = 16 KB
反过来,把 UB 的连续数据写回大矩阵的某个子块,就是把 srcGap=0(UB 连续)、dstGap=行间隔(GM 跳着写)。
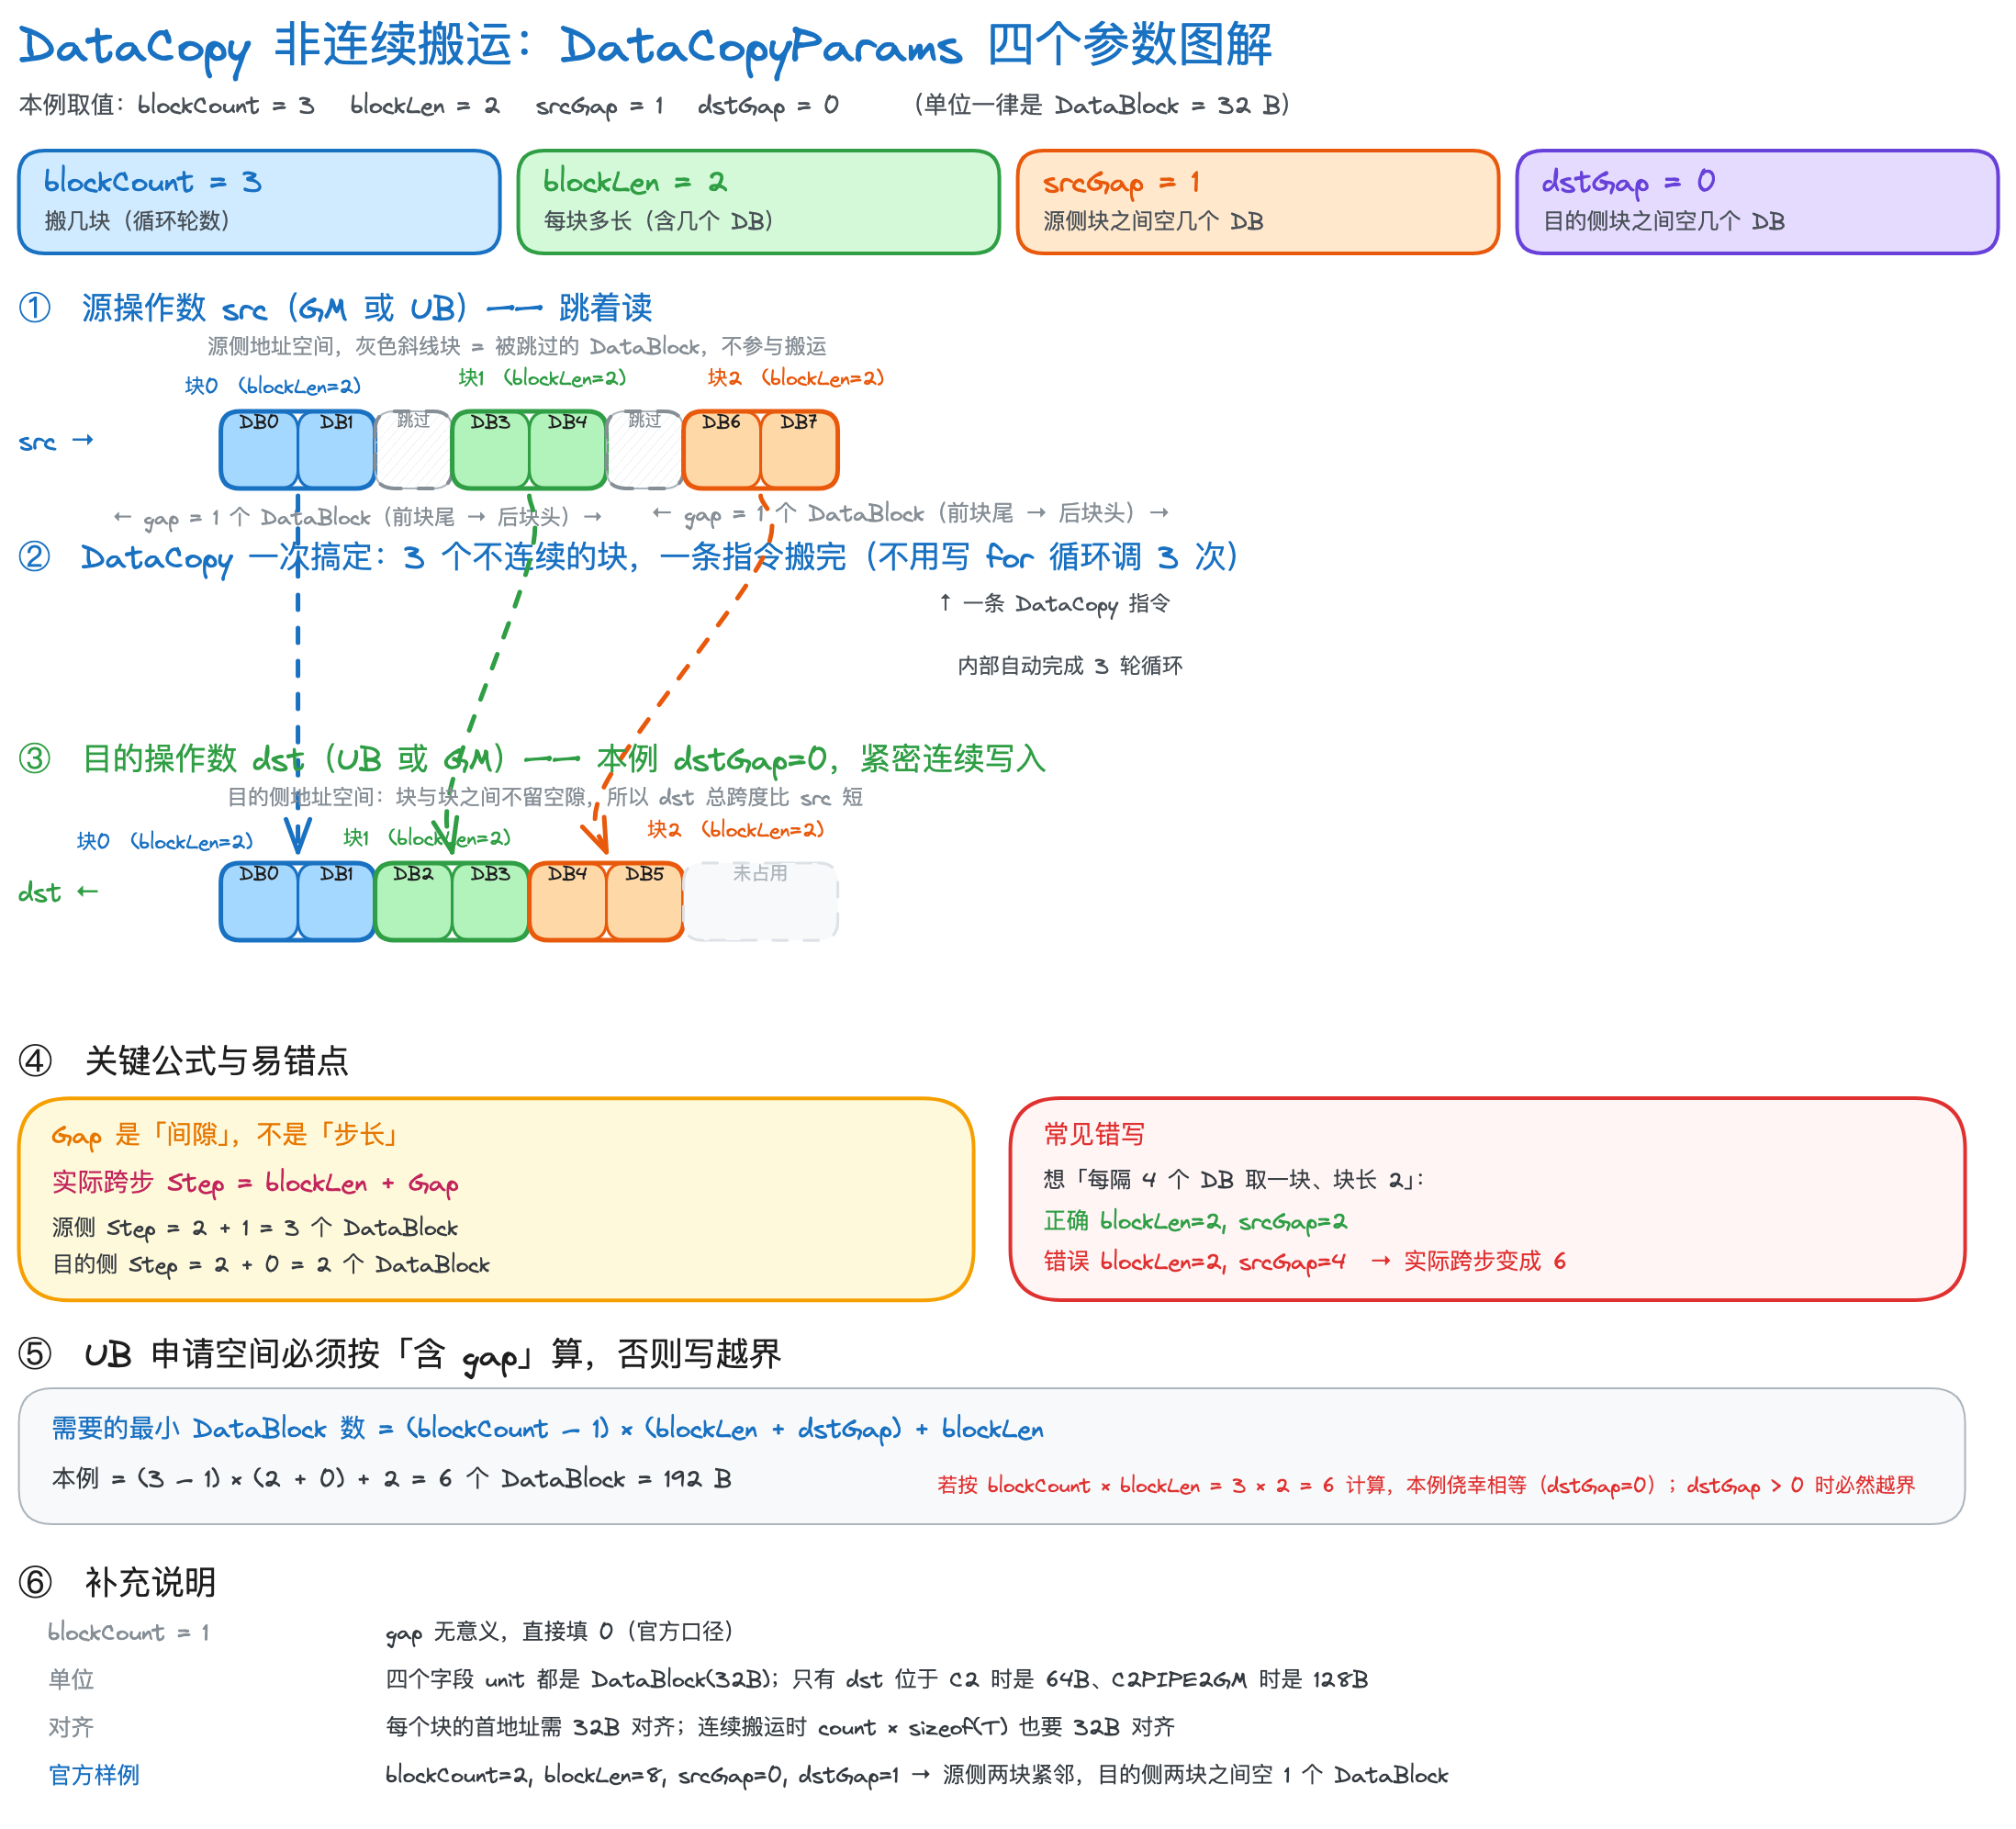
注:CANN 8.5 和 CANN 9.0 的 DataCopyParams 是同一个结构体,字段没变。 看到的命名差异(srcStride/dstStride vs srcGap/dstGap)不是版本差异,是新旧命名并存——头文件里它们是一个 union 的两个别名:
// 源码:${INSTALL_DIR}/.../kernel_struct_data_copy.h
struct DataCopyParams {
    __aicore__ DataCopyParams() {}
    __aicore__ DataCopyParams(const uint16_t count, const uint16_t len,
                              const uint16_t srcStrideIn, const uint16_t dstStrideIn)
        : blockCount(count), blockLen(len), srcStride(srcStrideIn), dstStride(dstStrideIn) {}
    uint16_t blockCount = DEFAULT_DATA_COPY_NBURST;   // 默认 1
    uint16_t blockLen = 0;
    // srcStride and dstStride will be deprecated, use srcGap and dstGap instead.
    union { uint16_t srcGap = 0;  uint16_t srcStride; };
    union { uint16_t dstGap = 0;  uint16_t dstStride; };
};
所以 params.srcGap = 4 和 params.srcStride = 4 写入的是同一块内存,完全等价。
官方从 9.0 起在文档上统一推 srcGap/dstGap,并把 srcStride/dstStride 标记为 "will be deprecated"。
- 增强搬运(8.5 起 / 9.0 保留并扩充)
template <typename T, typename U> __aicore__ inline void
DataCopy(const LocalTensor<T>& dst, const LocalTensor<U>& src,
         const DataCopyParams&         intriParams,
         const DataCopyEnhancedParams& enhancedParams);
| 入参 | 含义 |
|---|---|
intriParams |
搬运参数,DataCopyParams 类型 |
enhancedParams |
增强信息,DataCopyEnhancedParams 类型:含 blockMode(如 BLOCK_MODE_MATRIX 按分形搬运)、sidStoreMode、量化系数/Relu 标志等。支持源/目的类型不一致(T ≠ U)与 CO1→CO2 随路计算 |
地址对齐约束:
| 操作数位置 | 对齐要求 |
|---|---|
LocalTensor(UB / L1 / 通用) |
32 字节对齐 |
GlobalTensor(GM) |
按数据类型字节数对齐(通常 1 字节即可,无强约束) |
dstLocal 位于 C2 / BiasTable Buffer |
64 字节对齐 |
dstLocal 位于 C2PIPE2GM |
128 字节对齐 |
dstLocal 位于 L0C(NZ 格式) |
64 字节对齐 |
连续搬运的 count |
count * sizeof(T) 需 32 字节对齐 |
C2 场景的 c2Local 首地址偏移 |
按 index * cSize / 2 计算 |
1.4.2 运行与耗时
目标:扫 --block-dim 找出"最快"档。转置是 Vector(AIV)+ MTE + 标量 通路(不碰 Cube);本机物理单元为 Cube × 20 / Vector × 40(platform_config core_type_list=CubeCore,VectorCore,探针 AIC = 20 / AIV = 40)。--block-dim 是逻辑核([1, 65535]),于是要实测两个问题:① 加速曲线在哪一档停止下降(20 = 按 Cube 计 / 40 = 按 Vector 计)?② 超过物理单元后是否回升?
cd ~/asst4-ascend/part1

# 0) 首次跑建议 --clean 一次(kernels.cpp 改过,避免旧 .o)
python3 run_benchmark.py --kernel transpose -n 1024 --verify --clean

# 1) 扫 block-dim:1 → 128,每档都 --verify(正确性把关)
for B in 1 2 4 8 16 20 24 32 40 48 64 96 128; do echo "===== block-dim=$B"; python3 run_benchmark.py --kernel transpose -n 1024 --block-dim $B --verify; done

# 2) 大矩阵(4096² = 64 MB 访存)挑重点档复核(太重,不必全扫)
for B in 1 4 8 20 40 64 128; do echo "===== block-dim=$B"; python3 run_benchmark.py --kernel transpose -n 4096 --block-dim $B --verify; done
用双NPU的A3的环境运行(每个NPU 40 个 AIV):
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ npu-smi info
+------------------------------------------------------------------------------------------------+
| npu-smi 25.5.5                   Version: 25.5.5                                               |
+---------------------------+---------------+----------------------------------------------------+
| NPU   Name                | Health        | Power(W)    Temp(C)           Hugepages-Usage(page)|
| Chip  Phy-ID              | Bus-Id        | AICore(%)   Memory-Usage(MB)  HBM-Usage(MB)        |
+===========================+===============+====================================================+
| 7     Ascend910           | OK            | 169.2       47                0    / 0             |
| 0     14                  | 0000:0A:00.0  | 0           0    / 0          3108 / 65536         |
+------------------------------------------------------------------------------------------------+
| 7     Ascend910           | OK            | -           46                0    / 0             |
| 1     15                  | 0000:0B:00.0  | 0           0    / 0          2870 / 65536         |
+===========================+===============+====================================================+
+---------------------------+---------------+----------------------------------------------------+
| NPU     Chip              | Process id    | Process name             | Process memory(MB)      |
+===========================+===============+====================================================+
| No running processes found in NPU 7                                                            |
+===========================+===============+====================================================+
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose -n 1024 --verify --clean
[INFO ] --clean:删除 build-npu/ 做一次干净构建
[INFO ] 构建中(soc-version=Ascend910_9362)...
...
INFO ] 构建完成:/mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 1 个 AI Core
latency     : median 1347.092 us   min 1342.963 us   avg 1346.540 us
bandwidth   : 3.11 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致


developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ for B in 1 2 4 8 16 20 24 32 40 48 64 96 128; do echo "===== block-dim=$B"; python3 run_benchmark.py --kernel transpose -n 1024 --block-dim $B --verify; done
===== block-dim=1
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 1 个 AI Core
latency     : median 1346.834 us   min 1342.733 us   avg 1346.372 us
bandwidth   : 3.11 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=2
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 2 个 AI Core
latency     : median 683.997 us   min 680.037 us   avg 686.389 us
bandwidth   : 6.13 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=4
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 4 个 AI Core
latency     : median 354.535 us   min 351.734 us   avg 354.387 us
bandwidth   : 11.83 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=8
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 8 个 AI Core
latency     : median 185.677 us   min 184.847 us   avg 185.739 us
bandwidth   : 22.59 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=16
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 16 个 AI Core
latency     : median 105.414 us   min 104.134 us   avg 105.420 us
bandwidth   : 39.79 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=20
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 20 个 AI Core
latency     : median 103.434 us   min 101.994 us   avg 103.957 us
bandwidth   : 40.55 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=24
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 24 个 AI Core
latency     : median 84.333 us   min 83.523 us   avg 84.659 us
bandwidth   : 49.74 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=32
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 32 个 AI Core
latency     : median 65.563 us   min 64.432 us   avg 65.975 us
bandwidth   : 63.97 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=40
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 40 个 AI Core
latency     : median 65.172 us   min 63.702 us   avg 75.830 us
bandwidth   : 64.36 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=48
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 48 个 AI Core
latency     : median 84.983 us   min 83.934 us   avg 85.391 us
bandwidth   : 49.35 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=64
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 64 个 AI Core
latency     : median 66.432 us   min 65.573 us   avg 66.731 us
bandwidth   : 63.14 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=96
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 96 个 AI Core
latency     : median 67.303 us   min 66.263 us   avg 68.080 us
bandwidth   : 62.32 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=128
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 1024
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 128 个 AI Core
latency     : median 67.643 us   min 66.732 us   avg 69.999 us
bandwidth   : 62.01 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ for B in 1 4 8 20 40 64 128; do echo "===== block-dim=$B"; python3 run_benchmark.py --kernel transpose -n 4096 --block-dim $B --verify; done
===== block-dim=1
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 1 个 AI Core
latency     : median 21154.948 us   min 21111.956 us   avg 21152.699 us
bandwidth   : 3.17 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=4
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 4 个 AI Core
latency     : median 5307.902 us   min 5305.062 us   avg 5309.387 us
bandwidth   : 12.64 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=8
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 8 个 AI Core
latency     : median 2666.387 us   min 2663.316 us   avg 2666.403 us
bandwidth   : 25.17 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=20
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 20 个 AI Core
latency     : median 1097.654 us   min 1094.864 us   avg 1097.813 us
bandwidth   : 61.14 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=40
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 40 个 AI Core
latency     : median 600.884 us   min 598.874 us   avg 601.871 us
bandwidth   : 111.68 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=64
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 64 个 AI Core
latency     : median 684.777 us   min 682.977 us   avg 685.214 us
bandwidth   : 98.00 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
===== block-dim=128
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 128 个 AI Core
latency     : median 686.188 us   min 682.827 us   avg 686.029 us
bandwidth   : 97.80 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
汇总(1024²;median_us):
| block-dim | 1 | 2 | 4 | 8 | 16 | 20 | 24 | 32 | 40 | 48 | 64 | 96 | 128 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| median(μs) | 1347.1 | 686.4 | 355.1 | 185.7 | 105.4 | 103.4 | 84.3 | 65.6 | 65.2 | 85.0 | 66.4 | 67.3 | 67.6 |
| 加速比(vs 1) | 1.0× | 1.96× | 3.79× | 7.26× | 12.8× | 13.0× | 16.0× | 20.5× | 20.7× | 15.9× | 20.3× | 20.0× | 19.9× |
大矩阵(4096²;median_us):
| block-dim | 1 | 4 | 8 | 20 | 40 | 64 | 128 |
|---|---|---|---|---|---|---|---|
| median(μs) | 21155 | 5308 | 2666 | 1098 | 600.9 | 684.8 | 686.2 |
| 加速比(vs 1) | 1.0× | 3.99× | 7.94× | 19.3× | 35.2× | 30.9× | 30.8× |
实测结论:最优 --block-dim = 40,膝盖点对应的是 Vector(AIV = 40)而不是 Cube(AIC = 20)。
- 4096² 达到 35.2× 是决定性证据:如果并行执行单元只有 20 个(按 Cube 计),加速比不可能超过 20×。实测 35× → 该 kernel 实际并行在 40 个 Vector 单元上(转置不碰 Cube;
core_type_list=CubeCore,VectorCore、探针AIC = 20 / AIV = 40)——修正了"最多 20"的直觉。 - 超过 40 后持平或略回:64 / 96 / 128 时 1024² 停在 ~66–68 μs、4096² 停在 ~685 μs(比 40 的 601 还差一点)——多出的 block 与其他 block 共享物理 Vector 单元,不再加速;块列数不够分时多出的 block 直接空转退出,也不添乱。
- 负载均衡注释(1024² 的 48 档异常峰 85.0 μs):1024² 只有 64 个块列,48 核时 64 = 48×1 + 16,16 个核要扛 2 列 → 不均衡;而 40 / 64 核(64 列 ≈ 1.6 / 1 列)回到 65–66。4096² = 256 列,40 核 6.4 列/核、轮转分配基本均衡 → 近线性(1→4→8→20→40 的加速比 1 / 3.99 / 7.94 / 19.3 / 35.2)。块列数远大于核数时,轮转切分没有均衡性问题。
- 绝对值仍低:4096² 单核 21 ms → 40 核 0.6 ms(带宽 ~112 GB/s,仍远低于参考),因为每个 16×16 块做 32 次 32 B 级
DataCopy——基准实现的"碎搬迁"开销,EC 优化方向不变(带步长DataCopy/TransDataTo5HD)。
1.4.3 剖析与"是 memory-bound 还是 compute-bound"
取同一规模(4096²)、单核 vs 最优 40 核各剖析一次——对比引擎占比的变化,才能讲清楚"并行买到了什么":
cd ~/asst4-ascend/part1
python3 run_benchmark.py --kernel transpose -n 4096 --profile_name s3_tpose_4096_bd1
python3 run_benchmark.py --kernel transpose -n 4096 --block-dim 40 --profile_name s3_tpose_4096_bd40
如果需要Timeline的话,仿真流水图指令:
cd ~/asst4-ascend/part1

# 单核版(用 512² 看形态;要更小就用 --n 256)
msprof op simulator --soc-version=Ascend910_9362 --output=./sim_tpose_bd1 \
    ./build-npu/ascendc_kernels --kernel transpose -n 512 -m 512 --block-dim 1 --iters 1 --warmup 0 --reserve none

# 40 核版
msprof op simulator --soc-version=Ascend910_9362 --output=./sim_tpose_bd40 \
    ./build-npu/ascendc_kernels --kernel transpose -n 512 -m 512 --block-dim 40 --iters 1 --warmup 0 --reserve none
注意:上板 msprof op 不产生指令流水的 timeline——timeline(指令级 trace)只有仿真 msprof op simulator 才出 trace.json。所以"给这两个跑 timeline"要用仿真,而且 仿真 4096² 的 210 万条指令会跑到天荒地老,必须用小矩阵看形态
输出:
developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose -n 4096 --profile_name s3_tpose_4096_bd1
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/mnt/workspace/asst4-ascend/part1/profile /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels --kernel transpose --n 4096 --m 4096 --tile 16 --block-dim 1 --warmup 5 --iters 20 --reserve none --out /mnt/workspace/asst4-ascend/part1/out/transpose.bin
2026-10-10 01:06:15 [INFO]  Op profiling analysis start.
2026-10-10 01:06:15 [INFO]  Running device task: DeviceProf
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)
[INFO] <ProfData> Start profiling on device 0, kernel: matrix_transpose_0
[INFO] <WarmUp> Warm Up enabled. times:5
[INFO ] kernel=transpose n=4096 tile=16 blockDim=1
[INFO ] min=21410.747 us  median=21444.918 us  avg=21448.480 us  (3.13 GB/s)
2026-10-10 01:06:20 [INFO]  Profiling running finished. All task success.
2026-10-10 01:06:20 [INFO]  Start analyze kernel on device: device0, kernel: matrix_transpose_0, name is: 0
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [PipeUtilization] success.
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [ArithmeticUtilization] success.
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [L2Cache] success.
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [Memory] success.
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [ResourceConflictRatio] success.
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [MemoryL0] success.
2026-10-10 01:06:21 [INFO]  Save profiling data with metric [MemoryUB] success.
2026-10-10 01:06:21 [INFO]  Performance Summary Report:

        1) MTE2 bandwidth utilization lower than 80% when active.
        2) MTE3 bandwidth utilization lower than 80% when active.
        3) aivector compute usage lower than 20%.

2026-10-10 01:06:21 [INFO]  Operator Basic Information:

        Op Name: matrix_transpose_0
        Op Type: vector
        Task Duration(us): 21545.347656
        Block Dim: 1
        Mix Block Dim:
        Device Id: 0
        Pid: 10803
        Current Freq: 1650
        Rated Freq: 1650

2026-10-10 01:06:21 [INFO]  Profiling results saved in /mnt/workspace/asst4-ascend/part1/profile/OPPROF_20261010010615_QWUWKTPYVLAVCBRS
2026-10-10 01:06:21 [INFO]  Profiling data parse finished.
2026-10-10 01:06:21 [INFO]  Op profiling finish. Welcome to next use.
[INFO ] 本次剖析产出:/mnt/workspace/asst4-ascend/part1/profile/s3_tpose_4096_bd1(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 1 个 AI Core
latency     : median 21153.957 us   min 21111.005 us   avg 21144.814 us
bandwidth   : 3.17 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)

developer@8de626ef107b43269a92e55bdfcaea3c:.../workspace/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose -n 4096 --block-dim 40 --profile_name s3_tpose_4096_bd40
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/mnt/workspace/asst4-ascend/part1/profile /mnt/workspace/asst4-ascend/part1/build-npu/ascendc_kernels --kernel transpose --n 4096 --m 4096 --tile 16 --block-dim 40 --warmup 5 --iters 20 --reserve none --out /mnt/workspace/asst4-ascend/part1/out/transpose.bin
2026-10-10 01:06:52 [INFO]  Op profiling analysis start.
2026-10-10 01:06:52 [INFO]  Running device task: DeviceProf
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)
[INFO] <ProfData> Start profiling on device 0, kernel: matrix_transpose_0
[INFO] <WarmUp> Warm Up enabled. times:5
[INFO ] kernel=transpose n=4096 tile=16 blockDim=40
[INFO ] min=872.885 us  median=879.095 us  avg=881.531 us  (76.34 GB/s)
2026-10-10 01:06:57 [INFO]  Profiling running finished. All task success.
2026-10-10 01:06:57 [INFO]  Start analyze kernel on device: device0, kernel: matrix_transpose_0, name is: 0
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [PipeUtilization] success.
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [ArithmeticUtilization] success.
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [L2Cache] success.
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [Memory] success.
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [ResourceConflictRatio] success.
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [MemoryL0] success.
2026-10-10 01:06:57 [INFO]  Save profiling data with metric [MemoryUB] success.
2026-10-10 01:06:57 [INFO]  Performance Summary Report:

        1) MTE2 bandwidth utilization lower than 80% when active.
        2) MTE3 bandwidth utilization lower than 80% when active.
        3) aivector compute usage lower than 20%.

2026-10-10 01:06:57 [INFO]  Operator Basic Information:

        Op Name: matrix_transpose_0
        Op Type: vector
        Task Duration(us): 690.526184
        Block Dim: 40
        Mix Block Dim:
        Device Id: 0
        Pid: 10981
        Current Freq: 1650
        Rated Freq: 1650

2026-10-10 01:06:57 [INFO]  Profiling results saved in /mnt/workspace/asst4-ascend/part1/profile/OPPROF_20261010010652_SQIUEXZAKLXMUFGU
2026-10-10 01:06:57 [INFO]  Profiling data parse finished.
2026-10-10 01:06:57 [INFO]  Op profiling finish. Welcome to next use.
[INFO ] 本次剖析产出:/mnt/workspace/asst4-ascend/part1/profile/s3_tpose_4096_bd40(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 40 个 AI Core
latency     : median 603.894 us   min 600.844 us   avg 603.666 us
bandwidth   : 111.13 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
汇总(从各自目录的 OpBasicInfo.csv / PipeUtilization.csv 抄):
| 4096² · block-dim 1 | 4096² · block-dim 40 | |
|---|---|---|
| Task Duration(μs,profiler) | 21545 | 690.5 |
| 实访存(读 + 写) | 64 MiB | 64 MiB |
| 实现带宽(wall,GB/s) | 3.1 | 111.4 |
aiv_vec(Vector 占比) |
595.8 μs(2.8%) | 16.3 μs(2.4%) |
aiv_scalar(标量占比) |
20823 μs(96.6%) | 571.6 μs(83.5%) |
aiv_mte2(占比 / 有效带宽) |
13050 μs(60.6%)/ 9.6 GB/s | 509 μs(74.3%)/ 6.7 GB/s |
aiv_mte3(占比 / 有效带宽) |
11962 μs(55.5%)/ 10.4 GB/s | 294 μs(42.9%)/ 11.6 GB/s |
| 搬运指令数(in+out) | 1048576 + 1048576(≈210 万条) | 单 block 28673 ×40(总数同左) |
| L2 命中率 | ≈ 93.7% | ≈ 96.9%(读 99.99%) |
搬运指令数计算:
块数 = (4096/16)² = 65536;每块逐行搬 16 行 → 单向 65536×16 = 1048576,搬入/搬出各一份;Transpose 每块 1 次 = 65536 次。
均有实测佐证:Memory.csv 的 aiv_mte2_instructions = 1048576、aiv_mte3_instructions = 1048576,反推块数 1048576÷16 = 65536,与 (4096/16)² 两条独立路径吻合
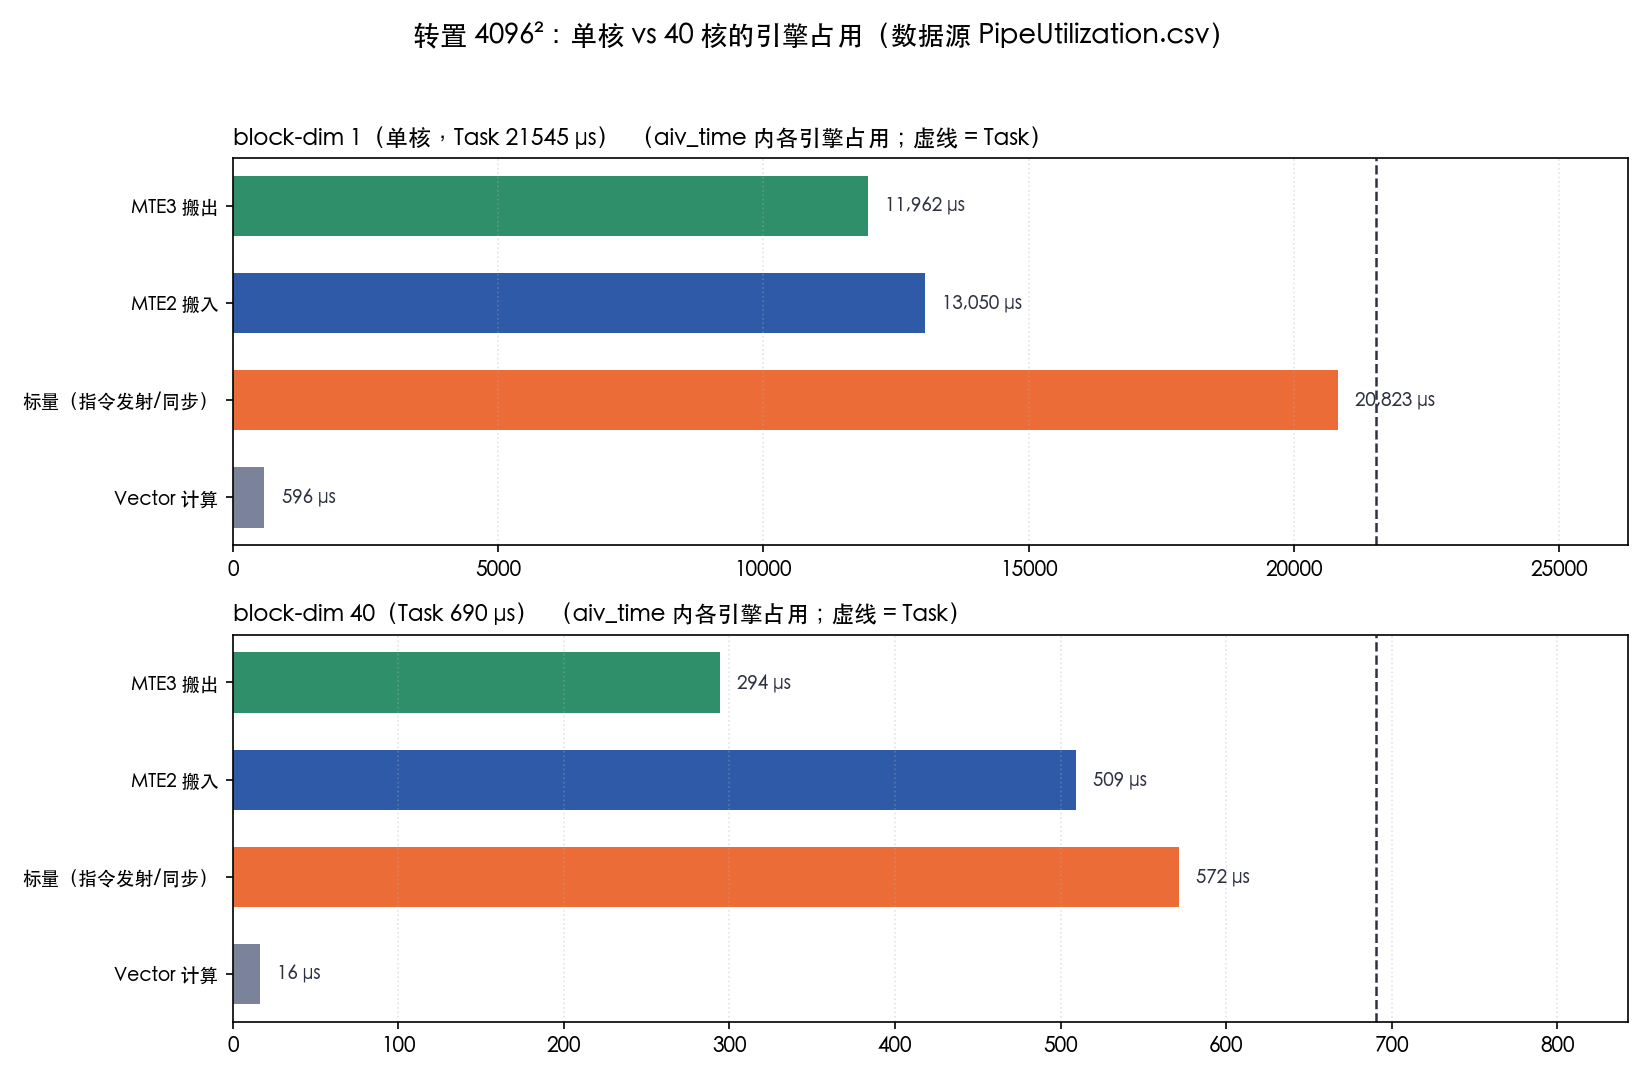
一眼就能看出:单核时"标量"条(20.8 ms)几乎顶满 Task(21.5 ms);40 核后同样这四根条一起缩到亚毫秒,标量仍是四根里最长(572 μs / 690 μs)——多核把 210 万条指令的发射与同步摊进了 40 个 Vector 单元,但"每次搬运的固定开销"结构没变。
判断路径(先用推理、再用 msprof 验证):
- 不是 compute-bound:转置的算术强度 ≈ 每元素 0 次浮点(
aiv_vec应接近 0 —— 唯一"算"是搬移本身),跟 §1.3b Roofline 的结论一致(AI ≪ ridge); - 是不是 bandwidth-bound 要看:单核版
aiv_mte2/mte3占比与有效带宽(预期很低,如 ~3 GB/s)→ 不是被带宽压着,而是被搬运指令数 + 标量发射/同步压着(每 16×16 块 32 次 32 B 级DataCopy,4096² 共 65536 块 × 32 = 2×1048576 ≈ 210 万条——profiler 实测aiv_mte2_instructions = 1048576、aiv_mte3_instructions = 1048576); - 40 核那一档的对比价值:并行把楼上那坨指令摊到 40 个 Vector 单元后,
aiv_mte2有效带宽应大幅上升(预期 ~110 GB/s 量级,与 wall 带宽一致)、标量占比相对下降——这组对比直接回答"多核买到了什么":买的是搬运指令的并行执行,而不是更高单核带宽。
实测结论(msprof 证据就是上面两列数字):
- 不是 compute-bound:两侧
aiv_vec都只有 ~2.5%(转置 ≈ 0 FLOP/元素)——msprof 的自动摘要也给出同样的判定(aivector compute usage lower than 20%); - 单核不是带宽-bound:MTE2/3 有效带宽只有 9.6 / 10.4 GB/s、usage_rate 2.6–3.1%(
lower than 80%)——真正压死时间的是 210 万条 32 B 级DataCopy的指令发射与同步(scalar 96.6%,aiv_time几乎被标量占满); - 40 核把指令流平分给 40 个 Vector 单元:21545 → 690 μs(31×,与 §1.4.2 的 35.2× 同量级)。比例变成 mte2 74.3% / scalar 83.5%——并行买的是"搬运指令的并行执行",不是"单笔搬运变快":每核有效带宽仍只有 7–12 GB/s,wall 带宽 111 GB/s 是 40 核叠加的结果;
- L2 命中 ≈ 94–97%:32 B 粒度 × 128 B 行 → 同一行被 4 次读取复用(顺带解释了
read datas ≈ 4×实数据);复用率高反而说明"不是没搬完,而是每次搬得太碎"; - 推论(接 §1.4.4):scalar(指令条数)才是瓶颈 → 优化方向 = 把每条
DataCopy搬大(带步长一次搬 16 行、或TransDataTo5HD),指令数降 64×,直接攻击 83–96% 这个标量占比;这比调 mask / 换算法更对症。
1.4.4 额外加分:优化方向
昇腾上没有原版那样的现成阈值(原文是 4096×4096 < 700 μs),所以要自建基线:
- 基线 1:
torch.transpose(x, 0, 1).contiguous()在 NPU 上的耗时(CANN 自带实现); - 基线 2:本节的朴素分块实现(1.4.2 的数据)。
达标建议:打败基线 1,或达到其 1.2 倍以内。可用的优化方向(按性价比排序):
- 换带步长的搬运:用
DataCopyParams一次搬 16 行(把每块的 32 次调用降到 2 次)。搬入侧{blockCount=16, blockLen=1, srcGap=n/16-1, dstGap=0}、搬出侧{16, 1, 0, m/16-1}(blockLen 与 gap 单位都是 DataBlock = 32 B;gap 是「前块尾→后块头」的间隔,等于行距减块长)。写srcStride/dstStride与写srcGap/dstGap等价(同一 union),随 9.0 文档用新名即可; - 换
TransDataTo5HD:官方明说"Transpose仅支持 16×16 大小的矩阵",更大的块要用它; - 消除物理转置(最有"平台味道"):如果转置只是后续算子的输入,直接在下一跳用 Matmul 的转置参数或换内存布局,比真搬一遍快得多——对应 NKI 里的
lhsT约定; - 多核并行:
--block-dim调大(当前基准版已支持按块列切核)。
EC 基线:CANN 自带实现(torch.transpose(...).contiguous())
原版的 EC 要求在 4096×4096 上打到 <700 μs;昇腾侧没有现成阈值,先用 CANN 自带的 torch 实现建基线(脚本 part1/torch_transpose_baseline.py,计时口径与本节一致:warmup 5 + iters 20,每次前后 npu.synchronize(),取 median/min/avg):
cd ~/asst4-ascend/part1
python3 torch_transpose_baseline.py --n 4096 2>&1 | grep -v "path string is NULL"        # 默认 fp16,与我们的 kernel 对齐
python3 torch_transpose_baseline.py --n 1024 2>&1 | grep -v "path string is NULL"         # 小规模对照
# (可选)python3 torch_transpose_baseline.py --n 4096 --fp32   # 好奇 fp32 差多少
脚本同时会打印一个对照组:纯 x.transpose(0,1)(只切视图、不搬数据)的耗时——用来区分"搬运开销"与"算子调度/下发开销"。
可比性说明:torch 基线没有
--tile/--block-dim这类旋钮(脚本只接受--n/--iters/--warmup/--fp32;传--tile会直接报unrecognized arguments)。它的 tiling 与用核数由 CANN 算子内部决定(默认就是用满设备)。所以我们这边的--block-dim 40才是与它同口径的配置;单核(--block-dim 1)的数字不能拿去和 torch 比。--tile是我们自己的分块参数——比的是"我们手动调优" vs "CANN 内部调优"。
输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 torch_transpose_baseline.py --n 1024 2>&1 | grep -v "path string is NULL"
device       : Ascend910B4   (torch.npu.is_available() = True)
baseline: x.transpose(0,1).contiguous()   shape=(1024, 1024)  dtype=torch.float16  device=npu:0
result       : device=npu:0  contiguous=True  shape=(1024, 1024)   ← 证明数据搬运确实发生在 NPU 上
latency     : median     90.700 us   min    84.933 us   avg    99.280 us   (20 iters)
bandwidth   :   46.244 GB/s  (按访存量 4.2 MB 估算)
纯 transpose(仅视图,不搬数据):    6.165 us —— 对照用:contiguous() 才是真实搬运开销

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 torch_transpose_baseline.py --n 4096 2>&1 | grep -v "path string is NULL"
device       : Ascend910B4   (torch.npu.is_available() = True)
baseline: x.transpose(0,1).contiguous()   shape=(4096, 4096)  dtype=torch.float16  device=npu:0
result       : device=npu:0  contiguous=True  shape=(4096, 4096)   ← 证明数据搬运确实发生在 NPU 上
latency     : median    177.883 us   min   164.043 us   avg   178.136 us   (20 iters)
bandwidth   :  377.265 GB/s  (按访存量 67.1 MB 估算)
纯 transpose(仅视图,不搬数据):    6.138 us —— 对照用:contiguous() 才是真实搬运开销
总结结果:
| 规模 | torch median(μs) | torch min(μs) | 纯 view 对照(μs) | 实现带宽 |
|---|---|---|---|---|
| 1024² | 90.700 | 84.933 | 6.165 | 46.2 GB/s |
| 4096² | 162.4 / 168.9 / 172.8 / 177.9(四次) | 148.8 / 160.7 / 155.2 / 164.0 | 6.1 – 6.4 | 377 – 413 GB/s |
scalar 瓶颈解读
§1.4.3 结论是「scalar(标量单元)占 96.6% / 83.5%,是真正的瓶颈」。 aiv_scalar 是标量单元在 AIV 时间轴上的占用,涵盖:
| 计入 scalar 的工作 | 本 kernel 里的来源 |
|---|---|
| 指令取指/译码/发射 | 每块 32 条 DataCopy + 1 条 Transpose + 队列指令 |
| 地址计算 | (bi*16 + r)*n + bj*16 这类 64 位地址运算,每条搬运前都要算一次 |
| 循环/分支控制 | 双层 bi × bj 循环、r/c 内层循环 |
| 同步指令与等待 | 每块 2 对 EnQue/DeQue → SetFlag/WaitFlag,以及与 MTE 队列的握手 |
但实测表明它不是"发射吞吐打满",而是"每条搬运指令太贵":
| 量 | bd1(单核) | 推算 |
|---|---|---|
aiv_time |
21551 μs = 35.56 M cycles(@1.65 GHz) | — |
| scalar 占用 | 20 823 μs = 34.36 M cycles(96.6%) | — |
| 标量侧指令(估计) | 2×1048576 条 DataCopy + 65536 条 Transpose + 同步/控制 ≈ 3–4 M 条 |
34.36 M ÷ 3–4 M ≈ 每条约 9–11 个周期 |
aiv_icache_miss_rate |
0.000002 | 取指不是问题(icache 几乎不缺失) |
也就是说:不是"指令发得太慢",而是"每条小搬运的固定代价太高"(地址/描述符构造 + 与 MTE 的同步握手)。所以优化杠杆只有一个方向——让每条搬运覆盖更多字节,而不是去抠发射周期。
| 措施 | 减少什么 | 预期收益 |
|---|---|---|
① 带步长 DataCopy 一次搬 16 行(参数见前面第 1 条) |
每块搬运指令 32 → 2 条(16×↓),连带地址计算与同步次数同降 | 标量侧指令 2.1 M → 131 k;单核若线性,scalar 20.8 ms → ~1.3 ms |
② 加大每块粒度(搬 16×64:blockLen=4、srcGap=n/16-4;转置时拆 4 个 16×16,或换 TransDataTo5HD) |
每字节的指令数再降 4× | 与 ① 叠加;Transpose 调用次数也降 |
③ TransDataTo5HD 取代 Transpose(用 repeatTimes 折叠,不是在外面套 K 次循环) |
转置指令每 16×16 一次 → 每 16×16×K 一次:repeatTimes=K、srcRepStride=1(每组前进 1 个 DataBlock)、dstRepStride=16(16 行 × 16 half) |
减少转置与配套同步点(相对 2 M 搬运量级较小)。 |
④ 地址强度削减:内层循环改成 ptr += n 累加、用 uint32 偏移、把 bi*16 提前算 |
每条搬运前的地址运算指令 | 与 ① 叠加(编译器不保证自动完成) |
⑤ 减少同步点:块做大后 EnQue/DeQue 次数等比下降;或用队列深度 >1 批量入队 |
SetFlag/WaitFlag 次数 |
与 ① 同向 |
| ⑥ 多核并行(已验证) | 不改指令数,把指令流分到 40 个 Vector 单元 | 实测 21.5 ms → 690 μs(31×);天花板 = AIV 数 40 |
| ⑦ 消除物理转置(若下游是 Matmul) | 整个 kernel | 最优解:用 Matmul 的转置输入约定,不做真实数据搬移(对应 NKI 的 lhsT) |
TransDataTo5HD 不是搬运,是数据排布转换,特别的,也可以用于二维矩阵数据块的转置。参考 TransDataTo5HD 功能说明。
一次 repeat 内可处理 512 Byte(16 个 DataBlock);指令内部循环 16 次,每次从 16 个指定 DataBlock 的对应位置取值,拼成一个新的 DataBlock 写到目的地址。
对于half,下面图例里每行就是一个DataBlock,正好16个元素。一次取16个DataBlock做转置:
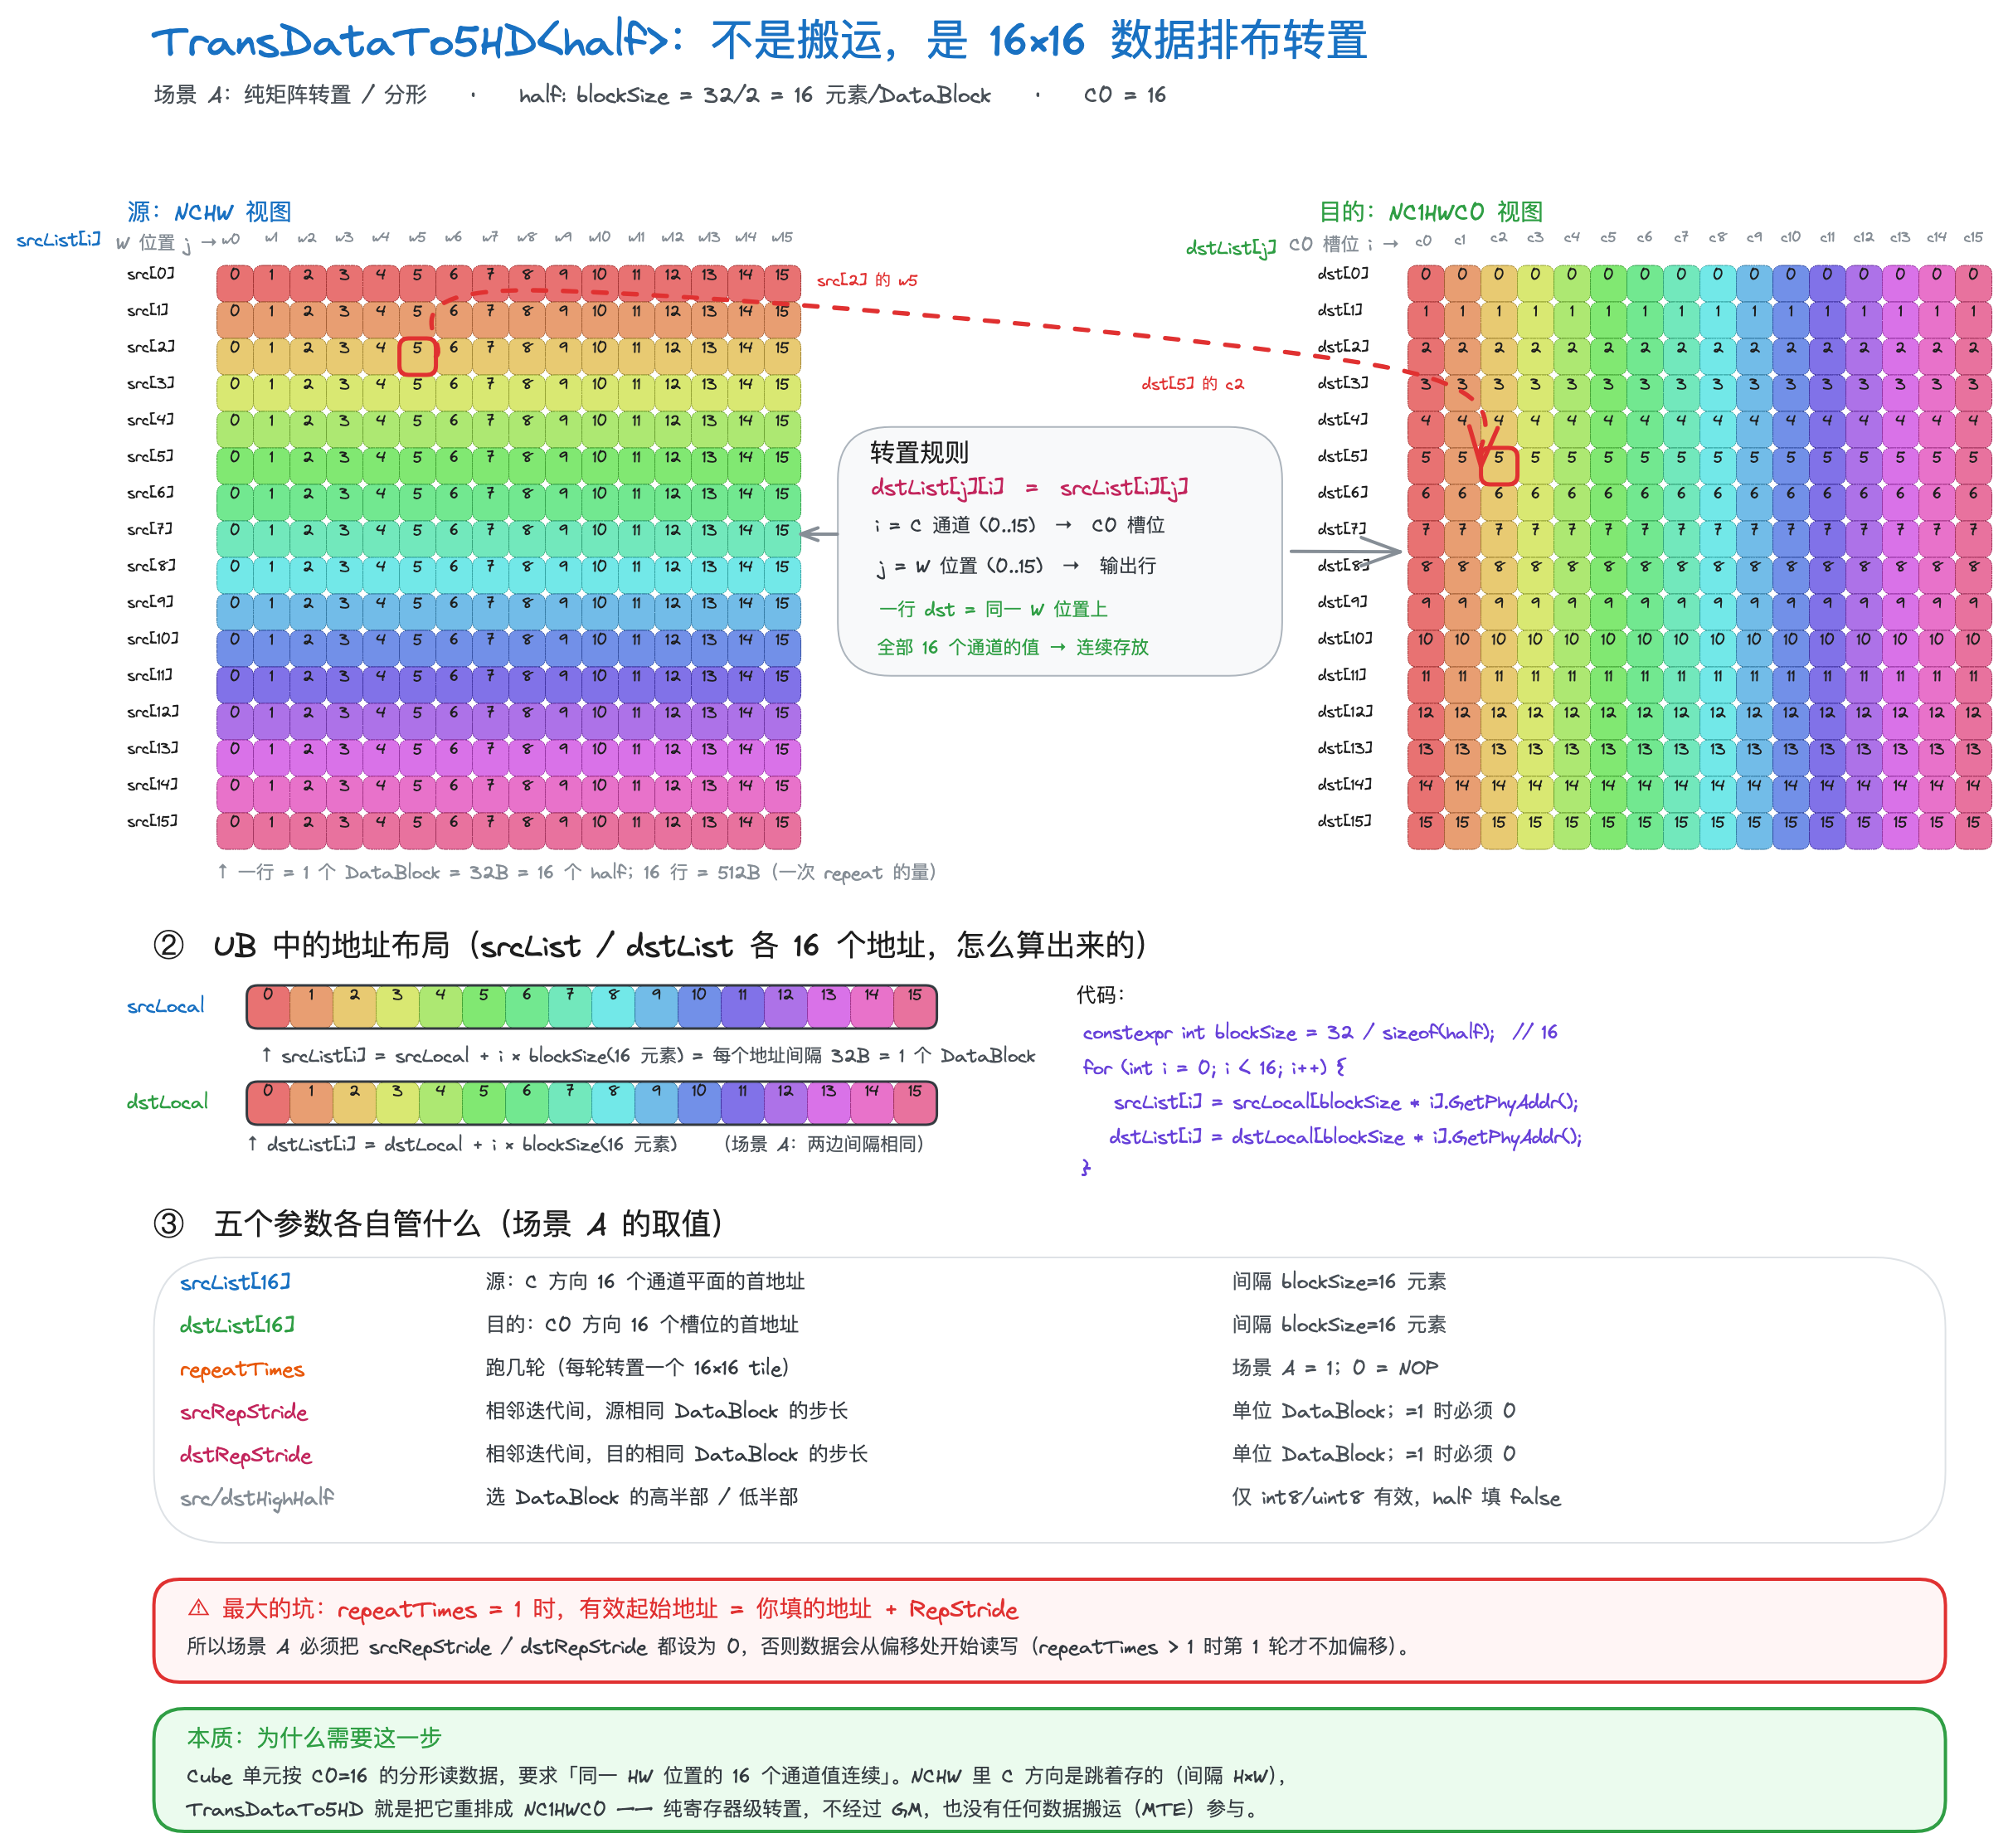
TransDataTo5HDParams 五个字段:
struct TransDataTo5HDParams {
    bool     dstHighHalf   = false;
    bool     srcHighHalf   = false;
    uint8_t  repeatTimes   = 1;
    uint16_t dstRepStride  = 0;
    uint16_t srcRepStride  = 0;
};
| 字段 | 类型 | 含义 | 备注 |
|---|---|---|---|
dstHighHalf |
bool |
数据写到 DataBlock 的高半部还是低半部 | 仅 int8_t / uint8_t 有效,half 忽略 |
srcHighHalf |
bool |
数据从 DataBlock 的高半部还是低半部读 | 同上 |
repeatTimes |
uint8_t |
重复迭代次数 | [0, 255],0 = NOP 空操作 |
dstRepStride |
uint16_t |
相邻迭代间,目的操作数相同 DataBlock 的地址步长 | 单位:DataBlock(32 B) |
srcRepStride |
uint16_t |
相邻迭代间,源操作数相同 DataBlock 的地址步长 | 单位:DataBlock(32 B) |
- 当 repeatTimes > 1 时,第 1 次 repeat 的有效起始位置 = 地址序列起始位置,第 2 次起每次加上
dstRepStride/srcRepStride; - 当 repeatTimes = 1 时,
有效起始位置 = 序列起始位置 + repStride—— 所以想让起始位置就是序列起点,必须把 repStride 置 0。
TransDataTo5HD 是 UB 内的搬运(dstList/srcList 的 TPosition 只允许 VECIN/VECCALC/VECOUT),数据必须驻留 UB。官方约束:
- 单次 repeat 处理 512 B(16 个 DataBlock),
repeatTimes ≤ 255→ 单次调用最多 127.5 KiB 输入; - 地址列表固定 16 项(一维恒为 16)、起始地址 32 B 对齐、src/dst 需独立缓冲(未见可原地复用声明)。
于是占用 UB 天花板:单缓冲
2S ≤ 192 KiB→ S ≤ 96 KiB;src/dst 各双缓冲4S ≤ 192 KiB→ S ≤ 48 KiB。本作业按 16×16(512 B)或 16×64(2 KiB)分块,src+dst 仅 1–4 KiB,离 UB 上限三个数量级——这条路的真正瓶颈仍是搬运指令数。
优化后的预期路径(用于 EC 定标):①+② 把单核指令数压到 ~1/64,标量不再是瓶颈 → 新的地板变成 MTE 搬运带宽(单核实测有效带宽 ~10 GB/s,64 MiB 往返 → 约 3–6 ms);再乘上 ⑥ 的多核并行(40×),量级可到 ~100–200 μs。届时再用 msprof 复核:aiv_scalar_ratio 应显著下降、aiv_mte2/3_active_bw 上升——即"瓶颈从标量转移到带宽"。
反面提醒:不要指望通过编译选项/循环展开来救——
aiv_icache_miss_rate ≈ 0已排除取指瓶颈,抠发射周期解决不了"每条搬运 ~10 周期"的固定代价;只有"每条搬更多字节"才动得了它。
优化算法实现说明
- 带步长
DataCopyParams:一个 tile 搬入/搬出各 1 条指令。
// 搬入:16 行 × K 个 DataBlock,行间距 (n/16 − K) 个 DataBlock
inParams  = {blockCount=16,        blockLen=K, srcStride=n/16-K, dstStride=0};
// 搬出:TILE_COLS 行 × 1 个 DataBlock(dst 在 UB 里连续)
outParams = {blockCount=TILE_COLS, blockLen=1, srcStride=0,     dstStride=m/16-1};
(注释里点明了 stride 的语义是"间隔"而非"间距"、以及 srcStride/dstStride 与 srcGap/dstGap 是同一 union。)
TransDataTo5HD取代Transpose
for (g = 0; g < K; ++g) {                       // 每个 16 列组一次
    for (i = 0; i < 16; ++i) {
        srcList[i] = src[i*TILE_COLS + g*16].GetPhyAddr();  // 第 i 行、第 g 组的起点
        dstList[i] = dst[(g*16 + i)*16].GetPhyAddr();       // 目的第 (g*16+i) 行
    }
    TransDataTo5HD<half>(dstList, srcList, params);          // 地址列表固定 16 项
}
关键点(注释里重点写了):Transpose 只搬运连续排布的 16×16,而 TransDataTo5HD 能直接搬运"行地址带间距"的 16 个 DataBlock —— 这正是 ① 换来的大 tile 所必需的配套能力,否则还得先 gather,优化就白做了。
指令数计算:
4096²、K=4(tile = 16 行 × 64 列):
| 每块/tile 指令 | 总计 | |
|---|---|---|
| 基准版 | 33(32 DataCopy + 1 Transpose)/ 16×16 | ≈ 216 万条 |
| 优化版 | 6(2 DataCopy + 4 TransDataTo5HD)/ 16×64 | ≈ 9.8 万条(22×↓) |
UB 占用:K=4 时 src/dst 各 2 KiB,K=16 时各 8 KiB——离 192 KiB 三个数量级。
实测:优化版 KernelTransposeOpt 的结果(EC)
按上面的 ①+②+③ 写了新 kernel(原版一行未动,新类 KernelTransposeOpt<K> + 新入口 matrix_transpose_opt,--kernel transpose_opt --tile 64 即 K=4):
cd ~/asst4-ascend/part1

# 先做正确性(小矩阵,快)
python3 run_benchmark.py --kernel transpose_opt -n 1024 --tile 64 --verify --clean

# 再对比性能(同规模、同核数)
python3 run_benchmark.py --kernel transpose     -n 4096 --block-dim 40 --verify
python3 run_benchmark.py --kernel transpose_opt -n 4096 --tile 64  --block-dim 40 --verify
python3 run_benchmark.py --kernel transpose_opt -n 4096 --tile 256 --block-dim 40 --verify   # K=16

# 剖析验证"瓶颈是否从 scalar 转移"
python3 run_benchmark.py --kernel transpose_opt -n 4096 --tile 64 --block-dim 40 --profile_name s3_opt_t64
# tar -czf profile.tar.gz profile/
输出结果:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt -n 1024 --tile 64 --verify --clean
......
[100%] Built target ascendc_kernels
[INFO ] 构建完成:/opt/atomgit/asst4-ascend/part1/build-npu/ascendc_kernels
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt  (可执行文件里的入口: transpose_opt)
n           : 1024
tile        : 16 行 × 64 列  (每个 tile 1024 个元素 = 2048 B)
block-dim   : 1 个 AI Core
latency     : median 344.046 us   min 334.716 us   avg 345.417 us
bandwidth   : 12.19 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose     -n 4096 --block-dim 40 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose  (可执行文件里的入口: transpose)
n           : 4096
tile        : 16 个元素  (单次搬运 32 B)
block-dim   : 40 个 AI Core
latency     : median 599.880 us   min 597.070 us   avg 599.989 us
bandwidth   : 111.87 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt -n 4096 --tile 64  --block-dim 40 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt  (可执行文件里的入口: transpose_opt)
n           : 4096
tile        : 16 行 × 64 列  (每个 tile 1024 个元素 = 2048 B)
block-dim   : 40 个 AI Core
latency     : median 228.665 us   min 222.874 us   avg 227.304 us
bandwidth   : 293.48 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt -n 4096 --tile 256 --block-dim 40 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt  (可执行文件里的入口: transpose_opt)
n           : 4096
tile        : 16 行 × 256 列  (每个 tile 4096 个元素 = 8192 B)
block-dim   : 40 个 AI Core
latency     : median 369.896 us   min 363.657 us   avg 368.428 us
bandwidth   : 181.43 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致
时间 / 带宽汇总(上面的输出结果里抄的 median 与带宽):
| 配置(4096² 除注明外都是 block-dim 40) | median(μs) | min(μs) | 实现带宽 |
|---|---|---|---|
基准版 transpose(16×16 逐行搬) |
599.9 | 597.1 | 111.9 GB/s |
优化 v1 --tile 64(K=4) |
228.7 | 222.9 | 293.5 GB/s |
优化 v1 --tile 256(K=16,反例) |
369.9 | 363.7 | 181.4 GB/s |
优化 v1 --tile 64(msprof 剖析那次,同参数) |
228.0 | 227.7 | 294.3 GB/s |
1024² · 单核 · --tile 64 |
344.0 | 334.7 | 12.2 GB/s |
三个可复现点:K=4 是最优列档(K=16 反而倒车到 181 GB/s);优化 v1 在 4096² 稳定在 ~228–229 μs / 293–294 GB/s;小规模(1024²)仍被固定开销压制(只有 12.2 GB/s)。
msprof op 分析:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt -n 4096 --tile 64 --block-dim 40 --profile_name s3_opt_t64
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/opt/atomgit/asst4-ascend/part1/profile /opt/atomgit/asst4-ascend/part1/build-npu/ascendc_kernels --kernel transpose_opt --n 4096 --m 4096 --tile 64 --block-dim 40 --warmup 5 --iters 20 --reserve none --out /opt/atomgit/asst4-ascend/part1/out/transpose_opt.bin
......
[INFO ] 本次剖析产出:/opt/atomgit/asst4-ascend/part1/profile/s3_opt_t64(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt  (可执行文件里的入口: transpose_opt)
n           : 4096
tile        : 16 行 × 64 列  (每个 tile 1024 个元素 = 2048 B)
block-dim   : 40 个 AI Core
latency     : median 228.024 us   min 227.674 us   avg 229.002 us
bandwidth   : 294.31 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
实测对比(数据源 report/asst4_profiles/profile-EC/s3_opt_t64;基准版为 report/asst4_profiles/profile-Step3):
| 指标 | 基准版 · bd1 | 基准版 · bd40 | 优化 v1(K=4, bd40) |
|---|---|---|---|
| Task(μs,profiler) | 21545 | 690.5 | 218.1 |
aiv_scalar_ratio |
96.6% | 83.5% | 46.8% |
aiv_vec_ratio |
2.8% | 2.4% | 7.5% |
aiv_mte2_ratio(time) |
60.6%(13050 μs) | 74.3%(509 μs) | 84.2%(179 μs) |
aiv_mte3_ratio(time) |
55.5%(11962 μs) | 42.9%(294 μs) | 78.8%(167 μs) |
| 搬运指令数(每捕获块) | 1048577 | 28673 | 513 |
| L2 读命中率 | 93.7% | ~94% | 19.5% |
aiv_vec_wait_ratio |
— | — | 96.9% |
aiv_mte2_wait_ratio / mte3 |
— | — | 99.1% / 99.5% |
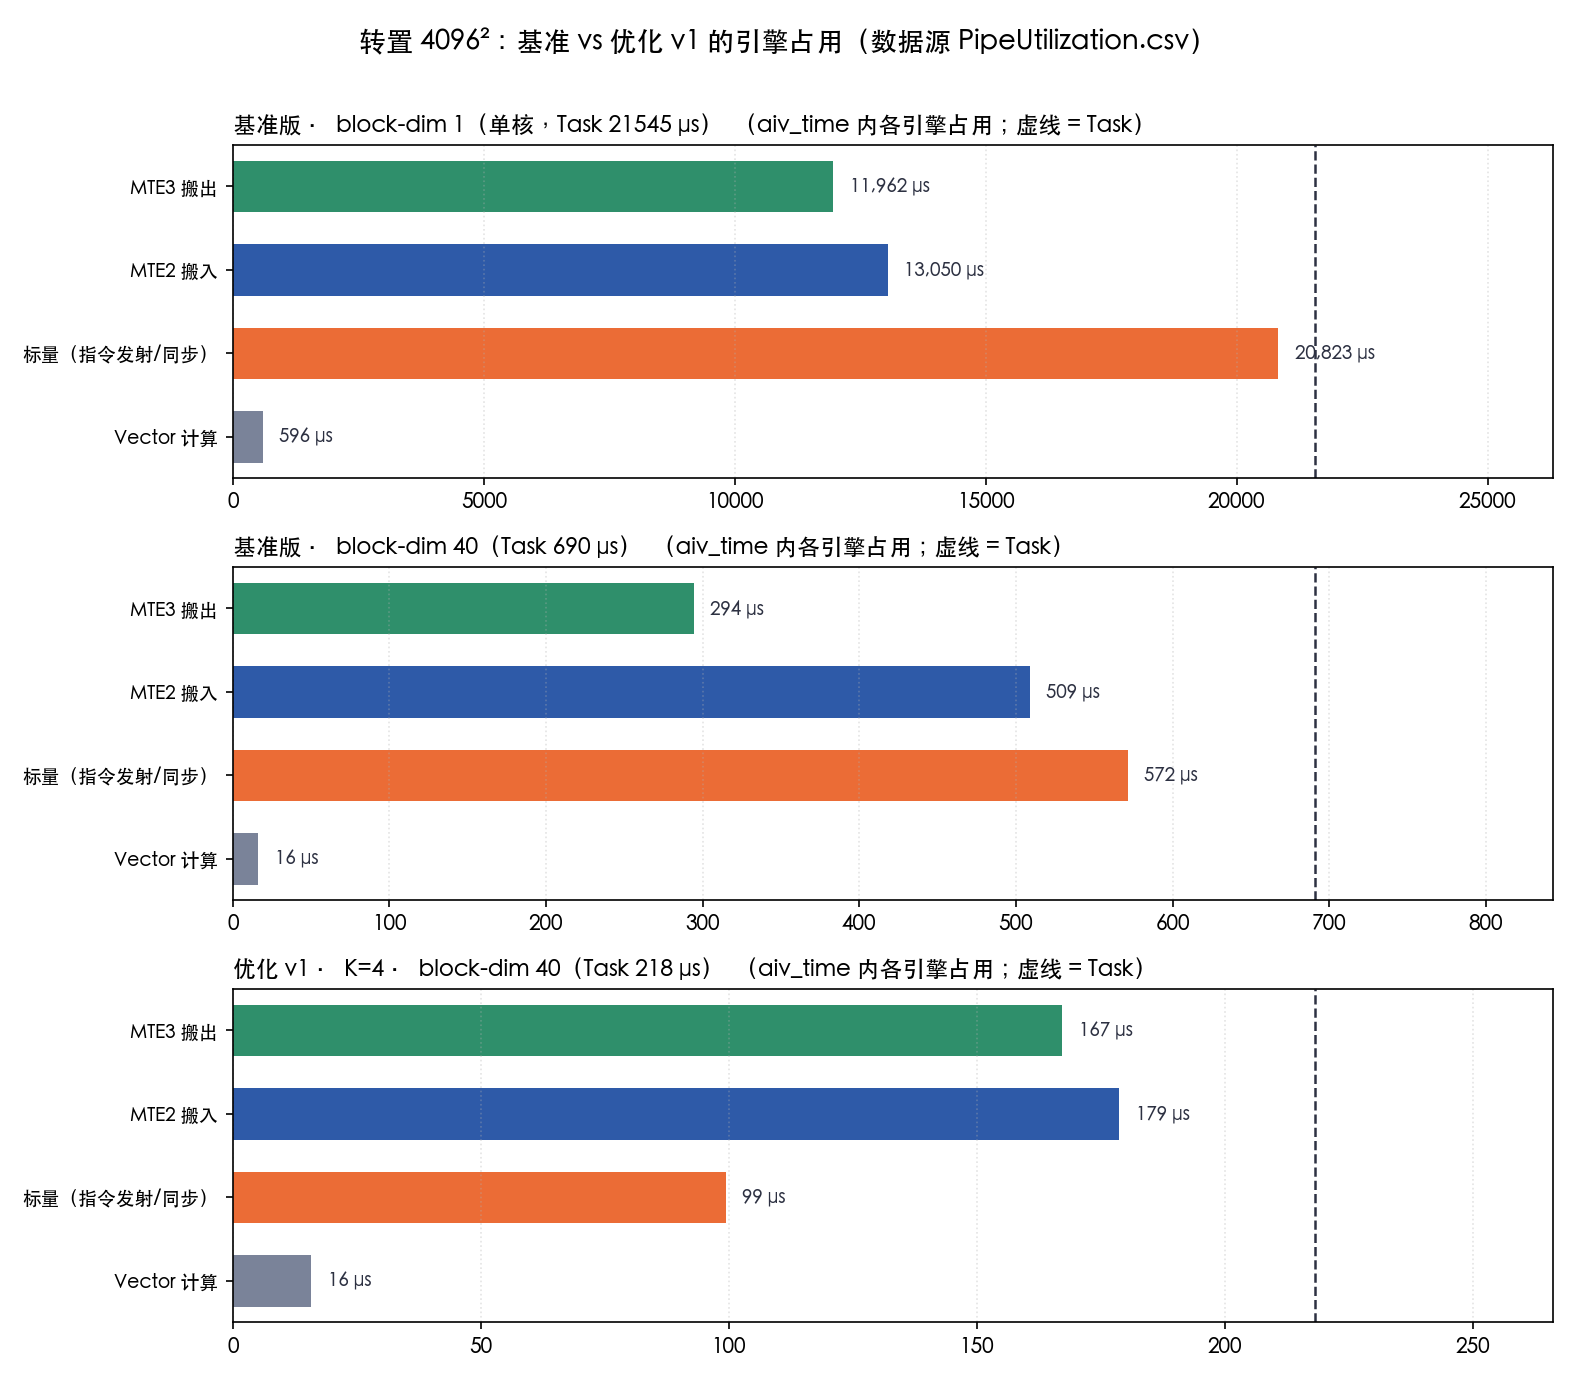
40 核后"标量"仍是四根里最长(572 μs / 690 μs);优化 v1 里它缩到最短(99 μs / 218 μs),MTE2 顶上(179 μs)——正是表格里
scalar_ratio 46.8%、mte2_ratio 84.2%的图形化。
结论:
scalar 不再是瓶颈:
aiv_scalar_ratio走完 96.6% → 83.5% → 46.8% 的三代迁移轨迹(基准 → 多核 → v1);瓶颈转移到搬运:
mte2_ratio升到 84.2%、mte3_ratio78.8%,Vector 计算仍只有 7.5%(非 compute-bound);单缓冲串行的铁证:
vec_wait = 96.9%、mte2_wait = 99.1%、mte3_wait = 99.5%——Vector 几乎永远在等 DMA。可以进一步优化,使用双缓冲要吃掉的部分(三次 wait 各 ~99% 说明流水里几乎没有任何重叠);
L2 读命中 93.7% → 19.5% 是"变好"而不是"变差":基准版的 93.7% 来自"32 B 粒度 × 128 B 行"导致一行被重读 4 次;v1 读取接近"每字节一次",DRAM 侧不再浪费;
列方向加大反而更差(实测):
--tile 256(K=16)只有 369.9 μs / 181 GB/s,远不如 K=4 的 228.7 μs / 293 GB/s——列方向的增益已经吃尽,这一路接下来的空间在"行方向(v2 的 128 行×256 B 行段)与搬运重叠",而不是继续加大 K。
优化 v2:双缓冲 + 128×128 大 tile(实现说明)
v1 的实测把剩下的差距指到了两处,v2 就是针对它们:
| 症状 | 原因 | v2 的做法 |
|---|---|---|
| 有大量时间不在算、也不在发指令 | 每 tile 是"搬入 → 转置 → 搬出"严格串行(队列只给 1 份 buffer),MTE2/MTE3 不同时工作 | 双缓冲:InitBuffer(que, 2, …)(队列深度仍按官方推荐保持 1,双缓冲靠缓冲份数),第 i 个 tile 在算/搬出时第 i+1 个 tile 的搬入已经在跑 |
| 实现带宽只有 293 GB/s | tile 只有 16 行 × 64 列,源行段仅 128 B(行距 8 KB),突发利用率低 | 大 tile:tile = 128 行 × 16K 列(8 个 16 行 band),K=8 时行段 256 B,每 tile 覆盖 16384 个元素(v1 的 16 倍) |
指令数(K=8,tile = 128×128):搬入 1 条 + 搬出 1 条 + 转置 8 条(每 16 行 band 一条,靠 repeatTimes=8 覆盖 128 列)= 10 条 / 16384 元素,比 v1 的 3 条 / 1024 元素再降 4.8×/每元素。
UB 预算:单份 buffer = 128×128×2 B = 32 KiB;两队列 × 双缓冲 = 4 份 = 128 KiB ≤ 192 KiB ✓(K=16 会到 256 KiB,超限——所以列方向最大 K=8)。
转置的地址推进:对第 b 个 16 行 band,repeatTimes=K、srcRepStride=1(每次前进 1 个 DataBlock = 下一个 16 列组)、dstRepStride=TILE_COLS(每次前进 16 行 × TILE_COLS 元素 = TILE_COLS 个 DataBlock);16 个源地址 = 该 band 的 16 行行首,16 个目的地址 = 第 0 列组的 16 个目的行、偏移到"本 band 的 16 元素切片"处。
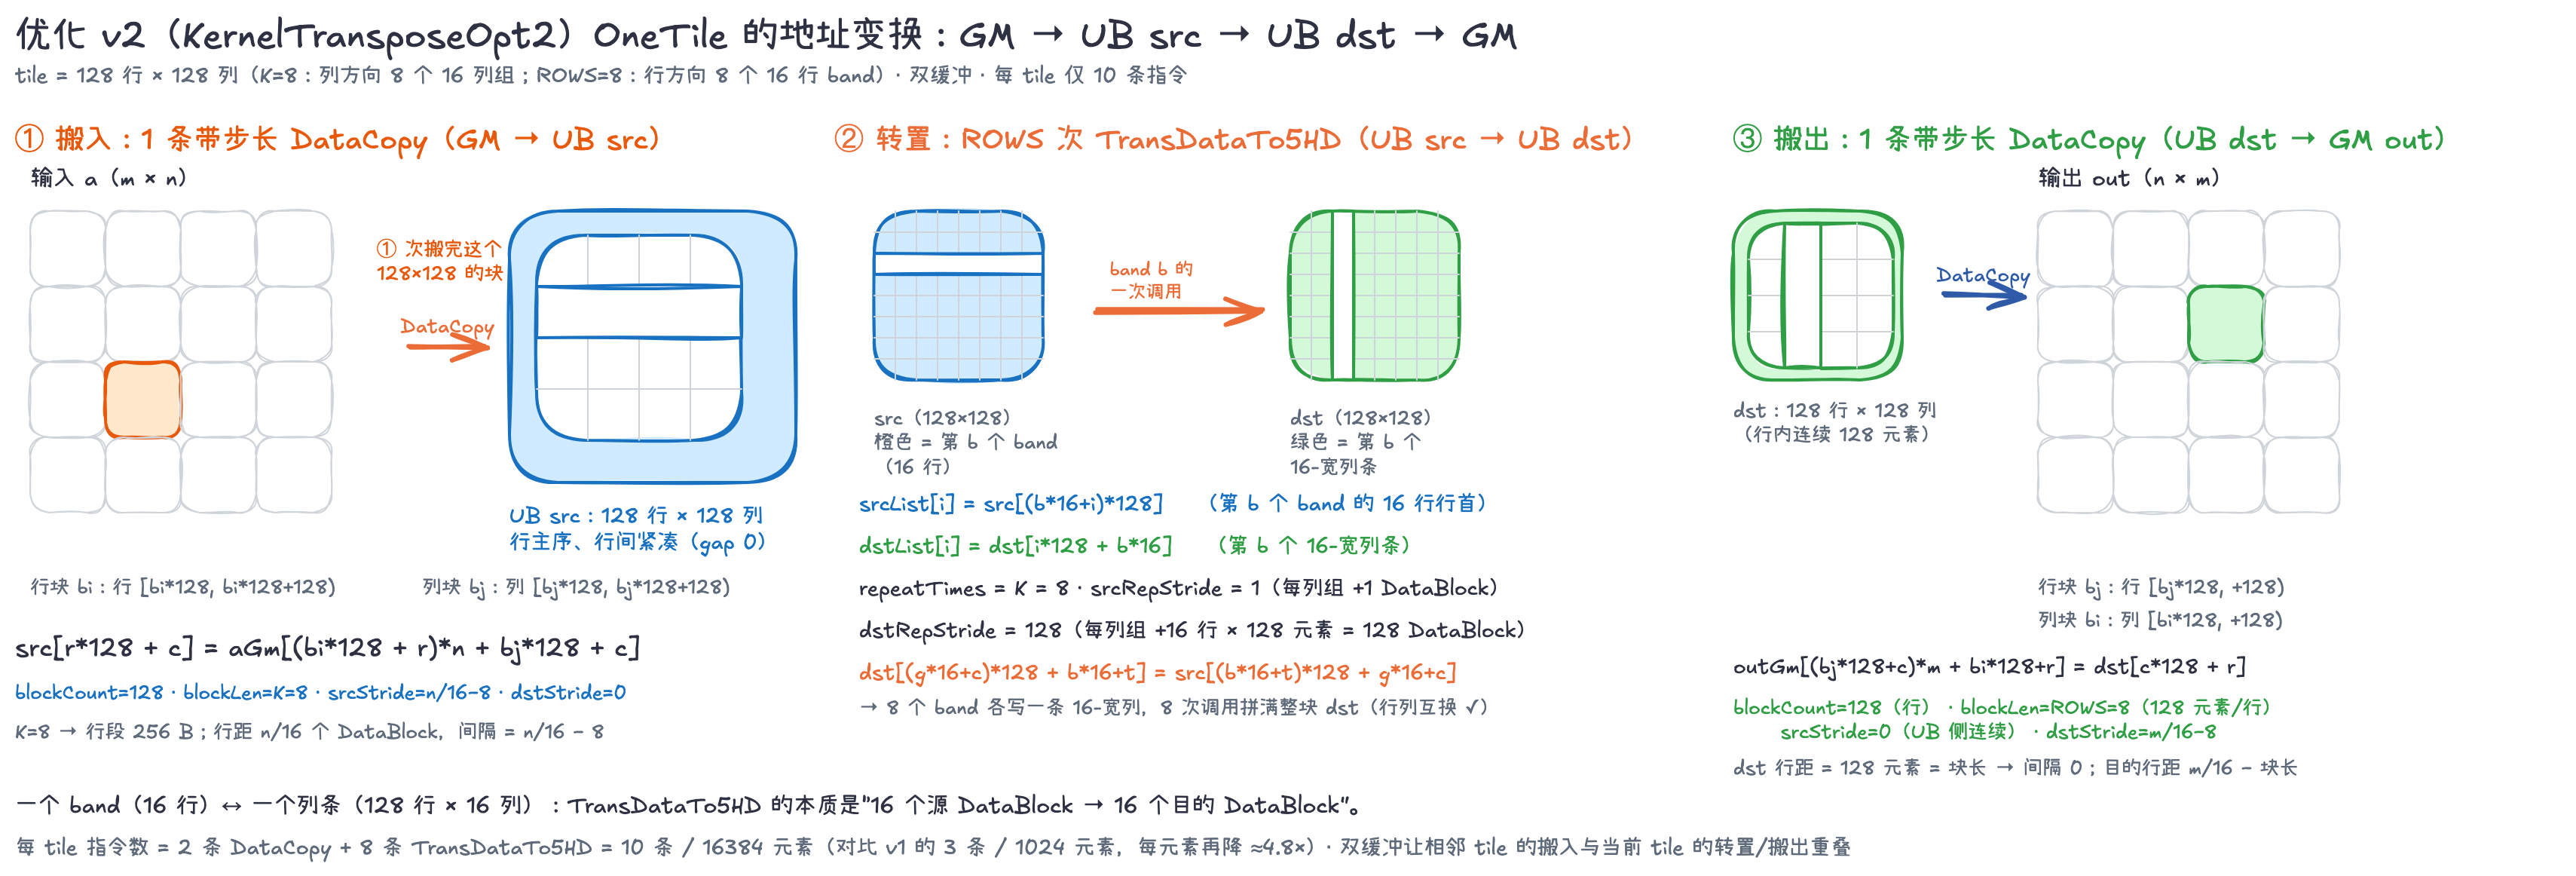
实现是新增的 KernelTransposeOpt2<K> + 新入口 matrix_transpose_opt2:
cd ~/asst4-ascend/part1

# 正确性优先(小矩阵)
python3 run_benchmark.py --kernel transpose_opt2 -n 1024 --tile 128 --verify --clean

# 与 v1、torch 基线对比(同规模、同核数)
python3 run_benchmark.py --kernel transpose_opt  -n 4096 --tile 64  --block-dim 40 --verify
python3 run_benchmark.py --kernel transpose_opt2 -n 4096 --tile 128 --block-dim 40 --verify
python3 run_benchmark.py --kernel transpose_opt2 -n 4096 --tile 64  --block-dim 40 --verify   # 对照:小列数

# 剖析(看双缓冲是否让 MTE2/MTE3 重叠、scalar 占比是否进一步下降)
python3 run_benchmark.py --kernel transpose_opt2 -n 4096 --tile 128 --block-dim 40 --profile_name s3_opt2_t128
# tar -czf profile.tar.gz profile/
约束:--tile 只支持 64/128,n % tile == 0,且 m 必须是 128 的整数倍(行方向固定 128 行一个 tile)。
输出:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt2 -n 1024 --tile 128 --verify --clean
[INFO ] --clean:删除 build-npu/ 做一次干净构建
[INFO ] 构建中(soc-version=Ascend910B4)...
......
INFO ] 构建完成:/opt/atomgit/asst4-ascend/part1/build-npu/ascendc_kernels
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt2  (可执行文件里的入口: transpose_opt2)
n           : 1024
tile        : 128 行 × 128 列  (双缓冲 2 份;每个 tile 16384 个元素 = 32768 B, UB 共 128 KiB)
block-dim   : 1 个 AI Core
latency     : median 70.011 us   min 67.631 us   avg 69.436 us
bandwidth   : 59.91 GB/s  (按访存量 4194304 B = 4.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt  -n 4096 --tile 64  --block-dim 40 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt  (可执行文件里的入口: transpose_opt)
n           : 4096
tile        : 16 行 × 64 列  (每个 tile 1024 个元素 = 2048 B)
block-dim   : 40 个 AI Core
latency     : median 227.963 us   min 227.523 us   avg 228.108 us
bandwidth   : 294.38 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt2 -n 4096 --tile 128 --block-dim 40 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt2  (可执行文件里的入口: transpose_opt2)
n           : 4096
tile        : 128 行 × 128 列  (双缓冲 2 份;每个 tile 16384 个元素 = 32768 B, UB 共 128 KiB)
block-dim   : 40 个 AI Core
latency     : median 54.061 us   min 51.460 us   avg 55.547 us
bandwidth   : 1241.35 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt2 -n 4096 --tile 64  --block-dim 40 --verify
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt2  (可执行文件里的入口: transpose_opt2)
n           : 4096
tile        : 128 行 × 64 列  (双缓冲 2 份;每个 tile 8192 个元素 = 16384 B, UB 共 64 KiB)
block-dim   : 40 个 AI Core
latency     : median 75.401 us   min 73.631 us   avg 75.267 us
bandwidth   : 890.03 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
[ OK ] 结果与 numpy 参考一致

atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part1$ python3 run_benchmark.py --kernel transpose_opt2 -n 4096 --tile 128 --block-dim 40 --profile_name s3_opt2_t128
[INFO ] msprof 采集(第 1 种调用形式):msprof op --output=/opt/atomgit/asst4-ascend/part1/profile /opt/atomgit/asst4-ascend/part1/build-npu/ascendc_kernels --kernel transpose_opt2 --n 4096 --m 4096 --tile 128 --block-dim 40 --warmup 5 --iters 20 --reserve none --out /opt/atomgit/asst4-ascend/part1/out/transpose_opt2.bin
2026-10-10 22:03:24 [INFO]  Op profiling analysis start.
2026-10-10 22:03:24 [INFO]  Running device task: DeviceProf
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)
[INFO] <ProfData> Start profiling on device 0, kernel: matrix_transpose_opt2_2
[INFO] <WarmUp> Warm Up enabled. times:5
[INFO ] kernel=transpose_opt2 n=4096 tile=128 blockDim=40
[INFO ] min=714.219 us  median=718.499 us  avg=720.149 us  (93.40 GB/s)
2026-10-10 22:03:28 [INFO]  Profiling running finished. All task success.
2026-10-10 22:03:28 [INFO]  Start analyze kernel on device: device0, kernel: matrix_transpose_opt2_2, name is: 0
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [PipeUtilization] success.
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [ArithmeticUtilization] success.
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [L2Cache] success.
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [Memory] success.
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [ResourceConflictRatio] success.
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [MemoryL0] success.
2026-10-10 22:03:28 [INFO]  Save profiling data with metric [MemoryUB] success.
2026-10-10 22:03:30 [INFO]  Performance Summary Report:

        1) MTE2 bandwidth utilization lower than 80% when active.
        2) MTE3 bandwidth utilization lower than 80% when active.
        3) aivector compute usage lower than 20%.

2026-10-10 22:03:30 [INFO]  Operator Basic Information:

        Op Name: matrix_transpose_opt2_2
        Op Type: vector
        Task Duration(us): 91.001823
        Block Dim: 40
        Mix Block Dim:
        Device Id: 0
        Pid: 2237
        Current Freq: 1650
        Rated Freq: 1650

2026-10-10 22:03:30 [INFO]  Profiling results saved in /opt/atomgit/asst4-ascend/part1/profile/OPPROF_20261010220324_BBZQDJOXEJJIRCUI
2026-10-10 22:03:30 [INFO]  Profiling data parse finished.
2026-10-10 22:03:30 [INFO]  Op profiling finish. Welcome to next use.
[INFO ] 本次剖析产出:/opt/atomgit/asst4-ascend/part1/profile/s3_opt2_t128(msprof 默认命名为 OPPROF_<时间戳>_<随机串>,已重命名)
[UB] Tiling 侧账本:GetCoreMemSize(UB) = 196352 B,GetCoreMemSize(L1) = 524032 B
[UB] (转置 kernel 不用这个公式,本次不比对)

kernel      : transpose_opt2  (可执行文件里的入口: transpose_opt2)
n           : 4096
tile        : 128 行 × 128 列  (双缓冲 2 份;每个 tile 16384 个元素 = 32768 B, UB 共 128 KiB)
block-dim   : 40 个 AI Core
latency     : median 54.420 us   min 51.991 us   avg 56.430 us
bandwidth   : 1233.17 GB/s  (按访存量 67108864 B = 64.000 MiB 估算)
结果:
| 4096² · 40 核 | median(μs) | 实现带宽 | 说明 |
|---|---|---|---|
| 基准版 | 600.9 | 111 GB/s | — |
| 优化 v1(K=4,单缓冲) | 228.8 | 293 GB/s | 瓶颈从 scalar 转移到搬运 |
| 优化 v2(K=8,128×128,双缓冲) | 54.1 | 1241 GB/s | 超 torch 3.0× |
| 优化 v2(K=4,128×64,双缓冲) | 75.4 | 890 GB/s | 行方向 128 行仍优于 v1 |
| torch 基线(CANN 自带实现) | 162.4 | 413 GB/s | 判定线 |
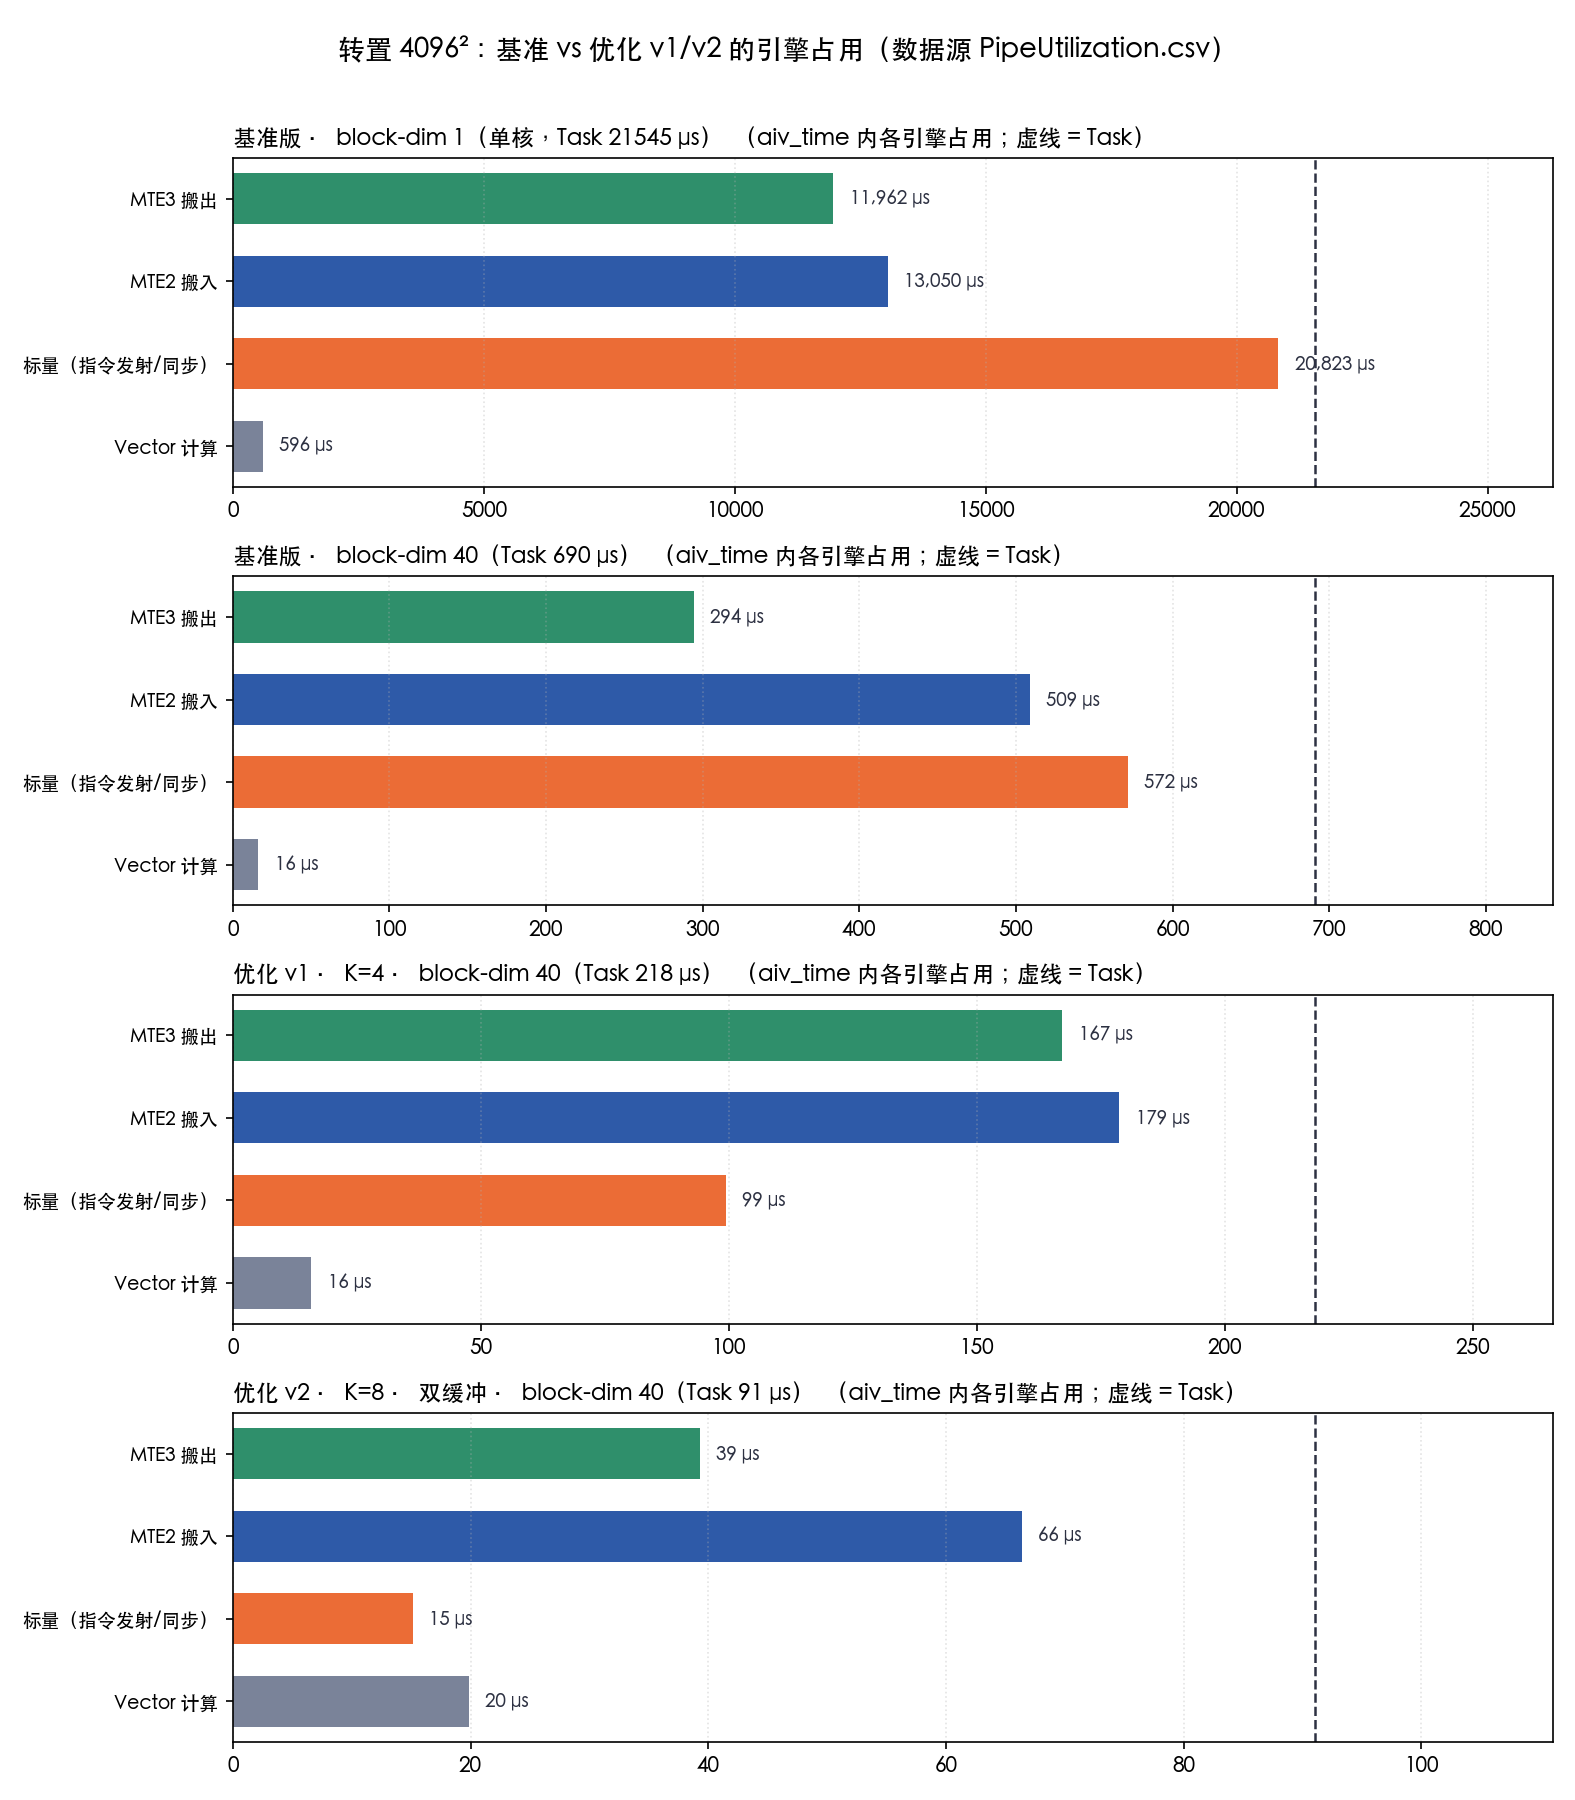
四行的演化一目了然:标量条
20.8 ms → 572 μs → 99 μs → 15 μs;v2 里 Vector(20 μs)第一次与 MTE 逼近(因为流水重叠让它和搬运并行在跑)。
v2 剖析(profile-EC/s3_opt2_t128)证实 "双缓冲生效":
| 指标 | 基准 bd40 | v1 | v2 |
|---|---|---|---|
aiv_scalar_ratio |
83.5% | 46.8% | 18.1% |
aiv_vec_wait_ratio |
— | 96.9% | 76.2% |
aiv_mte2_wait_ratio |
— | 99.1% | 0.27% ← MTE2 几乎不再等待(搬入永远有活干) |
aiv_mte3_wait_ratio |
— | 99.5% | 11.0% |
| L2 读命中率 | ~94% | 19.5% | 8.0%(每字节接近只读一次) |
| 搬运指令/每捕获块 | 28673 | 513 | 33 |
EC 判定:达标——v2 的 54.1 μs 远快于 torch 基线(162.4 μs,3.0×),也远低于原版 EC 阈值(4096² < 700 μs,12.9×),且两次 --verify 均 [OK]。
2. Part 2: Implementing a Fused Convolution - Max Pool Layer(70 分)
2.1 Matmul 高阶 API 使用
数据存储格式
分形(Fractal)是 Cube 的最小计算粒度:half 为 16×16(256 元素 / 512 B),int8 为 16×32 或 32×16——2201 与 3510 全系列都遵循,差异只在 2201 的 L0A 用 Zz,3510 的 L0A 用 Nz。
NPU 架构版本 2201(A2/A3)下 Cube 的分形格式要求(Ascend C 编程指南《Cube 矩阵计算编程》):
| 矩阵 | 存放位置 | 2201 要求格式 | 大X小x 含义 |
|---|---|---|---|
| A(左矩阵 [M,K]) | L0A Buffer | Zz | 大 Z = 分形块之间行主序;小 z = 块内行主序。A 逐行读取 → 行地址连续,左侧通道 DMA 连续读 |
| B(右矩阵 [K,N]) | L0B Buffer | Zn | 大 Z = 块之间行主序;小 n = 块内列主序。B 按列读取 → 列向量在分形内紧凑,右侧通道线性读完整列 |
| C(结果 [M,N]) | L0C Buffer | Nz | 大 N = 块之间列主序;小 z = 块内行主序。与后续 Vector / 多核按通道处理的衔接方便 |
ND(N-Dimension):N 维张量的通用线性格式,数据连续存放、行主序,是 GM 上最常见的落盘格式,也是我们(以及绝大多数算子)给 matmul 的输入格式。
ND (8×8,示意一个 4×4 分形):
  0  1  2  3 | 4  5  6  7        ← 一行存完再下一行,完全连续
  8  9 10 11 | 12 13 14 15
- Zz:分形内部行主序、分形之间行主序 → 0..3 与 8..11 各自连续(A 逐行读)
- Zn:分形内部列主序 → 该分形的第 0 列 0,4 / 第 1 列 1,5 …(B 逐列读)
- Nz:分形之间列主序、块内行主序(L0C 结果布局)
计算语义与使用流程
Matmul 的计算公式:C = A × B + Bias:
- A 为左矩阵,形状 [M, K];B 为右矩阵,形状 [K, N];C 存放结果,形状 [M, N];Bias 形状 [1, N],对 C 的每一行广播相加。
- 轴定义:M 轴 = A 矩阵纵向;K 轴 = A 横向 = B 纵向;N 轴 = B 横向;尾轴 = 矩阵最后一个维度。
Kernel 侧官方五步(Ascend C 程序里就是按这个顺序写):
1. 创建 Matmul 对象          Matmul<aType, bType, cType, biasType> mm;   ← 模板实例化,无运行期参数
2. 初始化 Tiling              mm.Init(cubeTiling, tpipe);   ← 按 Tiling 做资源划分
3. 设置 A / B / Bias          mm.SetTensorA(aGlobal); mm.SetTensorB(bGlobal); mm.SetBias(biasGlobal);
4. 完成矩阵乘                 mm.Iterate();  mm.GetTensorC(cLocal);   ← 每次算一块 baseM×baseN
5. 结束                       mm.End();
- 模板参数
MatmulType(决定 A/B/C/Bias 的类型信息,创建对象必填)
template <AscendC::TPosition POSITION, CubeFormat FORMAT, typename TYPE,
          bool ISTRANS = false, LayoutMode LAYOUT = LayoutMode::NONE,
          bool IBSHARE = false, TPosition SRCPOS = TPosition::GM>
struct MatmulType { ... };
| 参数 | 含义 |
|---|---|
POSITION |
数据所在内存逻辑位置。A/B 可为 GM / VECOUT / TSCM(Atlas 350);Bias 位置与 B 相同;C 可为 GM / VECOUT |
FORMAT |
数据的物理排布格式(ND / NZ 等;矩阵乘大多用 ND) |
TYPE |
数据类型。A/B:half / float / bfloat16t / int8_t / `fp8*` 等;C:float / int32_t 等(见官方"输入输出数据类型支持列表",本作业 half→float 即可) |
ISTRANS |
是否支持矩阵转置。true 时,运行时可通过 SetTensorA/B 的 isTransposeA/B 逐次决定转不转(false 则 isTranspose 参数被忽略);对应我们的转置 EC 结论——转置可以交给 Matmul 自己处理 |
LAYOUT |
数据排布。NONE = 普通 Matmul(默认);其它值 = Batch Matmul(BMNK 等排布,配合 IterateBatch) |
IBSHARE |
是否使能 IBShare(L1 Buffer 上 A/B 数据复用,少搬 MTE2)。A 和 B 只能有一个复用 |
SRCPOS |
仅 Atlas 350:当 POSITION 取 TSCM 时,TSCM 里数据的来源位置(默认 GM) |
- 模板参数
MatmulConfig(可选,配置模板与关键数值)
不配置 = 默认使能 Norm 模板。可选的预置模板:Norm(基本块多次小份搬入 L1)、MDL(一次"大包"搬入 L1)、IBShare(L1 复用)、BasicBlock / SpecialBasicBlock(无尾块时省流水同步)。主要配置参数:
| 参数 | 含义 |
|---|---|
basicM / basicN / basicK |
基本块(base 块)的 M/N/K 轴长度(元素数),与 Tiling 的 baseM/baseN/baseK 一致 |
singleCoreM / singleCoreN / singleCoreK |
单核内处理的 M/N/K 大小(SpecialBasicBlock 用) |
stepM / stepN |
A1/B1 里缓存方向上 baseM/baseN 的倍数(一级缓存深度) |
scheduleType |
数据搬运模式:INNER_PRODUCT(默认,沿 K 做 MTE1 循环搬运)/ OUTER_PRODUCT |
IterateOrder |
Iterate 时 C 分片的自动偏移迭代顺序(M 先还是 N 先) |
enUnitFlag |
使计算与搬运流水并行(Norm/IBShare 默认开,MDL 默认关) |
doMTE2Preload |
M/N 大时开启 M/N 方向的 MTE2 预加载,减小流水间隙(仅 MDL) |
enableDoubleCache |
IBShare 下 L1 同时缓存两块数据 |
intrinsicsCheck |
单核内轴 ≥ 65535 元素时是否循环搬入 GM→L1 |
isNBatch / enVecND2NZ / doSpecialBasicBlock 等 |
Batch、ND→NZ 矢量转换、SpecialBasicBlock 专项 |
- 对象创建与初始化
| 成员 | 原型 | 说明 |
|---|---|---|
| 构造 | Matmul<aType,bType,cType,biasType> mm; |
模板实例化即创建;无运行期参数 |
| 宏 | REGIST_MATMUL_OBJ |
创建时把 Tiling 参数一并初始化(Tiling 不变场景推荐) |
Init |
Init(const TCubeTiling*, TPipe* = nullptr) |
Tiling 参数在栈地址;按 Tiling 划资源 |
Init |
Init(const __gm__ TCubeTiling*, TPipe* = nullptr) |
Tiling 参数在 GM 地址 |
- 成员函数参数明细
| 成员 | 关键原型 | 参数含义 |
|---|---|---|
SetTensorA |
(const GlobalTensor<SrcAT>&, bool isTransposeA = false) |
设置左矩阵 A;isTransposeA:本次是否按转置读(需 MatmulType.ISTRANS=true)。另有 LocalTensor(TSCM/VECOUT)与标量重载(标量扩展为 [1,K] 全同值矩阵参加计算) |
SetTensorB |
(const GlobalTensor<SrcBT>&, bool isTransposeB = false) |
右矩阵 B,同上(标量重载扩展为 [K,1]) |
SetBias |
(const GlobalTensor<BiasT>&) / (const LocalTensor<BiasT>&) |
设置 [1,N] 的 Bias;参与 C = A×B + Bias |
DisableBias |
() |
清除 Bias 标志:即使 Tiling 里开了 isBias,调了这个也不再加 Bias |
Iterate |
template<bool sync=true> Iterate(bool enPartialSum = false) |
每调用一次算一块 baseM×baseN 的 C;内部自动偏移 A/B 首地址与 C 位置;sync:同步/异步模式;enPartialSum:是否把结果累加到已有 CO1(K 方向部分和;L0C 累加要求 singleCoreM==baseM && singleCoreN==baseN)。另有"用户自主管理 CO1"重载(多一个 localCmatrix 输出参数) |
GetTensorC |
template<bool sync=true> GetTensorC(const LocalTensor<DstT>& co2Local, uint8_t enAtomic = 0, bool enSequentialWrite = false) |
Iterate 后取 C 分片(输出到 VECIN 或 GM 版)。enAtomic:0=不原子 / 1=AtomicAdd / 2=AtomicMax / 3=AtomicMin;enSequentialWrite:true=连续写满 [baseM,baseN],false=非连续写 [singleCoreM,singleCoreN] 对应位置 |
IterateAll / WaitIterateAll |
template<bool sync=true> |
一次把所有迭代算完 / 异步等待 |
IterateBatch / WaitIterateBatch / IterateNBatch |
Batch Matmul | 批量场景专用;IterateNBatch 配合 MatmulConfig.isNBatch |
SetTail / SetBatchNum / SetHF32 |
专项 | 尾块、batch 数、HF32 中间精度 |
SetTensorScaleA/B、SetQuantScalar |
量化 | 量化场景的 scale / 标量 |
End |
() |
释放 Matmul 计算资源;多个 Matmul 对象之间切换计算时必须调用,防止资源冲突 |
其余成员:GetBatchTensorC、SetLocalWorkspace 等,见参考资料。)
- Tiling 结构体(
TCubeTiling)关键字段
Tiling 侧(Host)生成、Kernel 侧只读:
| 字段 | 含义 |
|---|---|
baseM / baseN / baseK |
基本块大小:一次矩阵乘算 baseM×baseN,沿 K 累加 baseK |
singleCoreM / singleCoreN |
单核处理的 M/N 大小 |
mIter / nIter |
单核内沿 M/N 的切分份数(singleCoreM 切成 mIter 份 baseM) |
stepM / stepN |
A1/B1 缓存方向上 baseM/baseN 的倍数(一级缓存能放几份) |
stepKa / stepKb |
A1/B1 沿 K 方向缓存 baseK 的倍数 |
depthA1 / depthB1 |
A1/B1 全载 A2/B2 的份数(对应多缓冲深度,类比我们转置的双缓冲) |
iterateOrder |
Iterate 输出 C 分片的自动偏移顺序 |
isBias |
是否参与 Bias 计算(DisableBias() 可在 kernel 侧再清掉) |
2.2 正确性实现
2.2.1 算法描述
一、算子定义(stride=1、无 padding、pool_size ∈ {1,2})
conv[b,co,oh,ow] = bias[co] + Σ_{i<FH} Σ_{j<FW} Σ_{c<C_in} X[b,c,oh+i,ow+j] · W[co,c,i,j]
out[b,co,ph,pw]  = max_{0≤r<pool, 0≤q<pool} conv[b,co,ph·pool+r, pw·pool+q]      (pool=1 时为恒等)
尺寸:H_out = H−FH+1、W_out = W−FW+1、H_pool = H_out/pool、W_pool = W_out/pool(作业保证整除)。
二、第一段:卷积 = FH·FW 次 matmul 累加(不是 im2col)
作业给定的 reduction:
for i in 0..FH-1:
  for j in 0..FW-1:
    output += matmul(transpose(weight[i,j,:,:]), shift(input, (i,j)))
四个要点决定了 kernel 与 host 的分工:
| 要点 | 含义 | 昇腾上的落点 |
|---|---|---|
收缩维是 C_in |
一次 matmul = (C_out × C_in) · (C_in × N),N 是输出空间位置 |
matmul 的 K = C_in(超过 baseK 时由库内部切成若干段在 L0C 累加) |
(i,j) 不是 K 的切分 |
9 次 matmul 是"不同片段的相加" | 同一块 L0C 跨 9 次累加:第 0 项 Iterate(enPartialSum=false) 先把 L0C 清零,其后 8 项 true 累加;每次 GetTensorC 取回的是"到当前为止的部分和",最后一次就是总和(UB 里不再做 Add) |
shift 没有原语 |
NKI 一句 shift(input,(i,j)) |
host 预排 Im′:每个输入行 r、每个列位移 j 存一个 (C_in, OWp) 连续段;行位移 i 不占布局维,由 kernel 用 r = oh+i 折进行索引(省 2/3 HBM,见 2.2.3) |
transpose(weight[i,j]) |
权重切片要转置 | host 预排 W′ 成 (FH·FW, C_out, C_in):第 (i,j) 切片本身就是连续的 (C_out, C_in),直接当 A 视窗 |
N 维取"一整行输出"(padOutWidth,16/32 对齐)而不是整幅 H_out×W_out——后者放不进 L0B,且分块会碎。
三、第二段:maxpool = 2×2 归约,全程在 UB 里
max 满足结合律,所以 2×2 的窗口 max 拆成"先按行、再按列"两步:
// 行方向:同一池化行算 pool 个卷积行(pool=2 → 相邻两行),逐元素取大
AscendC::Max(cur, cur, acc, baseM * padOutWidth);
// 列方向:偶列 / 奇列各取一半(GatherMask 内置固定模式 1 / 2,输出紧凑),再逐元素取大
AscendC::GatherMask(even, cur, 1, …);  AscendC::GatherMask(odd, cur, 2, …);
AscendC::Max(even, even, odd, baseM * poolOutWidth);
- 为什么放在 UB:融合的全部意义就是卷积结果不落 HBM——池化直接吃
GetTensorC落在 UB 的 C 块,只把池化行写回 GM,写回量因此是卷积输出的 1/4(=1/pool²)。 - bias 放在池化之后:
max(a+b, c+b) = max(a,c) + b,而 bias 只跟输出通道有关、与空间位置无关 → 每行只加poolOutWidth个元素,而不是每个 2×2 窗口各加一次。 pool=1与pool=2是同一条代码路径:for p in 0..pool-1在 pool=1 时退化成一次,Max/GatherMask被跳过——两种 pool 的一致性由同一份实现保证。
四、kernel 的循环结构
for (b = blockIdx; b < tiling.batchSize; b += GetBlockNum())     // 多核:按 batch 轮转
  for (cout0 = 0; cout0 < C_out; cout0 += baseM)                 // M 方向(输出通道)分块
    for (ph = 0; ph < tiling.tilePoolRows; ++ph) {               // 池化输出行(tile 局部)
      for (p = 0; p < poolSize; ++p)                             // 本池化行对应的 pool 个卷积行
        for (i = 0; i < FH; ++i)                                 // FH·FW 次位移 matmul
          for (j = 0; j < FW; ++j) {
            mm.SetTensorA(W′[(i,j)][cout0 …]);                   // (baseM, C_in)
            mm.SetTensorB(Im′[b][ph·pool + p + i][j], false);    // (C_in, OWp)
            while (mm.Iterate<true>(i || j))                     // 第 0 项清零、其后累加 L0C
              mm.GetTensorC<true>(cur, false, true);             // → (baseM, OWp)
          }
      // 行 max →(pool>1)列 max → +bias → DataCopy 写回 padded 池化输出
    }
五、数据流通(一轮完整前向,按时间顺序)
| # | 阶段 | 谁做 | 数据形态(内层维在右) | 所在存储 |
|---|---|---|---|---|
| 1 | 造数 + 落盘 | host(确定性 LCG) | X (B,C_in,H,W)、W (C_out,C_in,FH,FW)、bias (C_out) |
HOST → x/w/bias.bin(对拍基准) |
| 2 | 权重预排(一次) | host RepackW |
W′ (FH·FW, C_out, C_in) |
HOST → GM(常驻,不进流水) |
| 3 | 输入预排(每流水单元) | host RepackIm |
Im′ (tileBatch, rIn, FW, C_in, OWp),rIn = tileRows+FH−1 |
HOST ping-pong 缓冲 |
| 4 | H2D(异步、双缓冲) | copyStream |
只拷本单元 bCur×rIn 行 |
GM imDev[parity] |
| 5 | 取 A/B 段 | cube(框架随路 ND→分形) | A (baseM, C_in)、B (C_in, OWp) |
GM → L1 → L0A / L0B |
| 6 | 矩阵乘 + 9 次累加 | AIC | L0C 部分和 (baseM, OWp) |
L0C(128 KB) |
| 7 | 取 C | fixpipe GetTensorC |
(baseM, OWp),ND |
L0C → UB |
| 8 | 行 max / 列归约 / +bias | AIV(vector) | (baseM, OWp) → (baseM, poolOutWidth) |
UB |
| 9 | 写回 | MTE3 DataCopy |
池化 padded (B, C_out, H_pool, poolOutWidth) |
UB → GM |
| 10 | 回读 + 裁列 | host | (B, C_out, H_pool, W_pool) |
GM → HOST → out.bin |
| 11 | 对拍 | Python | 与 numpy / torch 双基准逐元素比 | HOST |
host 侧把第 3–9 步按 (batch tile × 行 tile) 切成若干"流水单元"、双缓冲重叠(本单元的 RepackIm+H2D 与上一个单元的 kernel 并行);kernel 内部再按 batch 轮转分给多个 AI Core。这两条流水线的正确性前提(尤其是 host 缓冲也要防覆写)见 2.4.1。
2.2.2 分块设计
分块约束:片上三个 Buffer 决定一次 matmul 能算多大:
| Buffer | 存放 | 容量 |
|---|---|---|
| L0A | 左矩阵 A(baseM × baseK) |
64 KB |
| L0B | 右矩阵 B(baseK × baseN) |
64 KB |
| L0C | 结果 C(baseM × baseN) |
128 KB |
若按"长宽相等"的正方形分块相乘(M=N=K=s),三个约束取交集 → s 的上限:
| dtype | L0A/L0B 限制(更紧) | L0C 限制 | 交集 s_max(16 对齐) | 双缓冲后(L0A/L0B /2) |
|---|---|---|---|---|
| fp16 | s² ≤ 32768 → s ≤ 181 |
s² ≤ 65536 → s ≤ 256 |
176 | 128 |
| fp32 | s² ≤ 16384 → s ≤ 128 |
s² ≤ 32768 → s ≤ 181 |
128 | 80(保守取 64) |
长宽相等时,M 和 K 的最大值是同一个 s——fp16 单缓冲 176(双缓冲 128)、fp32 单缓冲 128(双缓冲 80)。实际实现会再留 L1 双缓冲余量,所以表中线一般取"双缓冲后"的值(这也是常见常量 128 的来源)。
Cube 的分形(fractal)粒度是 16×16(half 为 16×16 = 256 元素/512B)。硬件一次处理一个分形,所以
| 维度 | 硬件要 16 倍数吗 | 作业里的实际值 | 我们要不要 pad |
|---|---|---|---|
| M(A 行数,输出通道) | 最好像 | C_out 是 128 倍数(作业保证)✅ |
不用,天然对齐 |
| K(收缩维,输入通道) | 最好像 | C_in 是 128 倍数(作业保证)✅ |
不用,天然对齐 |
| N(B 列数,输出宽) | 最像 | W_out = W−FW+1 = 222/14,不保证 ❌ |
pad → OWp = padOutWidth = align(W_out, 16)(pool>1 且 fp16 时 32,见 2.2.3 ③) |
分块策略:M 按输出通道切、N 取整行、行按 tile 切
算法的"FH*FW 次 matmul 累加"里一次 matmul 的 N 维是输出空间位置,但整幅 H_out×W_out(大图 ≈ 5 万)放不进 L0B,所以 N 只取"一整行输出 + pad"(padOutWidth),行方向再按 tile 切(--tile-rows)。三个片上 Buffer 的账(上限都按"元素数"口径,ε = 每元素字节数):
| 约束 | 表达式 | fp32 上限 | fp16 上限 |
|---|---|---|---|
| L0A(A 块) | baseM × baseK ≤ 64 KB / ε |
16384 元素 | 32768 |
| L0B(B 块) | baseK × baseN ≤ 64 KB / ε |
16384 | 32768 |
| L0C(C 块) | baseM × baseN ≤ 128 KB / ε |
32768 | 65536 |
| UB(C + 暂存 + 池化暂存 + bias) | 2·baseM·baseN + … |
见 2.2.3 ⑤ | 同 |
实际取值(ComputeTiling 的默认值,也就是跑过对拍的四档):
| 场景 | C_in / C_out | 行宽 OWp | baseN | baseK | baseM | baseM×baseK | baseK×baseN | baseM×baseN |
|---|---|---|---|---|---|---|---|---|
| fp16 小图 32×16 | 128 / 128 | 16 | 16 | 128 | 128 | 16384 ✅ | 2048 ✅ | 2048 ✅ |
| fp32 小图 32×16 | 128 / 128 | 16 | 16 | 64 | 64 | 4096 ✅ | 1024 ✅ | 1024 ✅ |
| fp16 大图 224×224 | 256 / 256 | 224 | 224(整行) | 128 | 128 | 16384 ✅ | 28672 ✅ | 28672 ✅ |
| fp32 大图 224×224 | 256 / 256 | 224 | 224(整行) | 64 | 64 | 4096 ✅ | 14336 ✅ | 14336 ✅ |
- 大图也是一整行:L0B 的约束是
baseK × baseN,而baseK被钉在 64(fp32)/128(fp16)——C_in=256时 K 由库内部切成⌈C_in/baseK⌉段在 L0C 里累加,不占 N 的额度,所以baseN=224(整行)放得下(fp16 28672≤32768、fp32 14336≤16384)。行宽 224 本身是 16 的倍数,不必再切半行。 - baseM 由 L0A 与 UB 联立:fp32 取 64、fp16 取 128——UB 里要同时放 C 块、暂存行(pool>1 再加池化暂存),预算见 2.2.3 ⑤。
- 行方向:
--tile-rows每 tile 算 16 行卷积输出(pool=2 时 = 8 行池化输出),输入只排rIn = tileRows + FH − 1 = 18行。
GEMM 收缩维 K 的处理:
enPartialSum = false(默认):Iterate 前把 L0C 那块先清零(cmatrix init),算的是独立结果;enPartialSum = true:不清零,把本次结果累加到 L0C 已有的部分和上。
kernel 循环结构(一次前向;pool=1 时内层退化、跳过 Max/GatherMask):
for (b = blockIdx; b < batchSize; b += GetBlockNum())          // 多核:按 batch 轮转
  for (cout0 = 0; cout0 < C_out; cout0 += baseM)               // M:输出通道切片
    for (ph = 0; ph < tilePoolRows; ++ph)                      // 池化输出行(tile 局部)
      for (p = 0; p < poolSize; ++p)                           // 该池化行对应的 pool 个卷积行
        for (i, j ∈ FH×FW) {                                   // FH*FW 次位移 matmul
            SetTensorA(W′[(i,j)][cout0 起] (baseM, C_in))       // GM 连续段(host 预排)
            SetTensorB(Im′[b][ph·pool+p+i][j] (C_in, OWp))      // 位移段,GM 连续(host 预排)
            while (Iterate<true>(i||j)) GetTensorC(cur)         // L0C 部分和累加(K 切段也在 L0C 内)
        }
      // 行 max →(pool>1)列归约 → +bias → DataCopy 写回 padded 池化输出
2.2.3 数据存储格式处理
Matmul<> API 要求:A/B/C 在 GM 上按 ND(连续行主序) 存储。
MatmulType<TPosition::GM, CubeFormat::ND, T>告诉库"A 在 GM 上是 ND 线性排布"。SetTensorA/B之后,库在 GM→L1→L0A/L0B 的搬运链上随路完成 ND→分形(中间经 L1 的 Nz 转换),GetTensorC取回时再转回 ND——使用者看不到、也不用参与。
一块数据在每个阶段的形态(分块之后实际参与计算的维度组织):
| 阶段 | 张量 | 维度(按实际存储顺序,内层维在右) | 内层连续维 | 说明 |
|---|---|---|---|---|
| 应用层 | X | (B, C_in, H, W) |
W |
NCHW 原始布局,与 Trainium2 版契约一致 |
| 应用层 | W | (C_out, C_in, FH, FW) |
FW |
注意不是 (FH,FW,C_in,C_out)(落盘 w.bin 就是它) |
| 应用层 | bias | (C_out) |
— | 与输出通道同序 |
| host 预排 | Im′ | (tileBatch, rIn, FW, C_in, OWp) |
OWp |
每流水单元一份;rIn = tileRows + FH − 1(含 halo) |
| host 预排 | W′ | (FH·FW, C_out, C_in) |
C_in |
只排一次,常驻 GM,不进流水 |
| kernel 取 B | Im′[b][oh+i][j] |
(C_in, OWp) |
OWp |
直接是 matmul 的 B(K=C_in, N=OWp) |
| kernel 取 A | W′[(i,j)][cout0 起] |
(baseM, C_in) |
C_in |
matmul 的 A(M=baseM, K=C_in) |
| cube | L0C 部分和 | (baseM, OWp) |
— | 分形 16×16,跨 9 次 (i,j) 累加 |
| UB(vector 前) | C 行 | (baseM, OWp) |
OWp |
GetTensorC 落点(ND) |
| UB(vector 后) | 池化行 | (baseM, poolOutWidth) |
poolOutWidth |
行 max → 列归约之后 |
| GM 写回 | out | (B, C_out, H_pool, poolOutWidth) |
poolOutWidth |
池化后的 padded 布局 |
| host 回读 | out.bin |
(B, C_out, H_pool, W_pool) |
W_pool |
裁掉 pad 列,与参考实现同形 |
OWp = padOutWidth(16/32 对齐,见 ③)、poolOutWidth = padOutWidth / poolSize;H_pool / W_pool就是outPoolHeight / outPoolWidth。
① Im′:输入预排(把 shift 消成"换一个段地址")
Im′[b][r][j][c][ow'] = X[b, c, oh0 + r, ow' + j]     当 ow' + j < W
                       0                             否则(越界列补 0)

b ∈ [0,tileBatch)  r ∈ [0,rIn)  j ∈ [0,FW)  c ∈ [0,C_in)  ow' ∈ [0,OWp)
段 (r, j) 的地址 = ((b·rIn + r)·FW + j) · (C_in·OWp)
段内 (C_in, OWp) 连续(c 主序、ow' 连续)——这正是 matmul 的 B 段 (K=C_in, N=OWp),SetTensorB(段基址, false) 直接吃,kernel 里没有任何 copy / shift。
这些维是怎么来的:课程图(Mapping Convolution to Matrix Multiplication)只画了一次 matmul 的骨架(输入 (C_in, H×W)、权重 (C_in, C_out)、结果 (H×W, C_out)),位移与 FH·FW 次累加都是我们自己加上去的:
| 从哪来 | 落到哪个维 | 为什么 |
|---|---|---|
| 单次 matmul 的 B | 最内两维 (C_in, OWp) |
收缩维 C_in × "一整行输出位置"。整幅 H_out×W_out ≈ 5 万 远超 L0B 一次能装的位置数(baseK×N ≤ 64 KB/ε:fp16 baseK=128 → N≤256,fp32 baseK=64 → N≤128),所以 N 只取一整行 |
shift 的列位移 j |
FW 维 |
每个 j 一份错列数据;段内列偏移 = j |
shift 的行位移 i |
不占维(折进行索引) | Im′[b][r][j][c][ow'] 的右边没有 i:同一输入行 r 里 (0,j)/(1,j)/(2,j) 内容完全相同,i 只决定"取第 oh+i 行" |
| halo(卷积窗跨 tile 边界) | rIn = tileRows + FH − 1 行 |
一个 tile 的输出行 oh ∈ [oh0, oh0+tileRows) 只依赖输入行 [oh0, oh0+rIn) |
| 列越界 | 补 0 | ow'+j ≥ W 时窗口滑出输入,贡献必须为 0(无 padding、stride=1) |
i折叠 = 省 2/3 的 packed 输入:推导版(冗余):(B, H+1, FH*FW, C_in, OWp) ≈ 9 份图像 落地版(精简):(tileBatch, rIn, FW, C_in, OWp) ≈ 每 tile 3 份 × rIn 行 段地址:((b * tileInputRows + (oh + i)) * FW + j) * (C_in*OWp)再叠加 tile 行切片(
--tile-rows,每块输出只重排rIn行输入),HBM 里驻留的 packed 输入从"整幅 × 9 份"缩到"rIn行 × 3 份"。注意 pad 列(
ow' ≥ W_out但< OWp)里不是 0:那些位置对应真实存在的输入列,算出来是有值但无意义的数;host 最后按W_pool裁掉(大图W_out=222 → OWp=224,每行多算 2 列,占比可忽略)。
为什么必须 host 预排(而不是 kernel 里现位移):高阶 API 的 B 要求 GM 上是连续的 ND 段——没有 NKI 那种"从 SBUF 窗口 slice + reshape"的能力;在 kernel 里现位移要么经 UB 中转 + 额外 GM 往返(贵),要么就是本布局的 host 预排(一次排好、零搬运)。
② W′:权重预排(消掉 transpose,A 视窗一次可用)
W′[(i·FW + j)][co][c] = W[co][c][i][j] → (FH·FW, C_out, C_in)
第 (i,j) 切片本身就是连续的 (C_out, C_in),matmul 的 A 直接取从 W′[(i,j)][cout0 · C_in] 起的 (baseM, C_in) 段。
⚠️ 必须逐元素重排:源布局 (C_out, C_in, FH, FW) 里 c 的存储步长是 FH·FW,用一行 memcpy 拷 C_in 个"连续"字节会把 c 拷成错序(症状:量级全对、5–35% 随机偏差、与 co 相关,见 2.4 第 7 条)。
③ 输出:padded 的"池化后"布局
outGm: (B, C_out, H_pool, poolOutWidth)

  padOutWidth  = align(W_out, 16)    … 一般情况(matmul 的 N 要 16 对齐:cube 的 N 分形是 16,fp32 的 C0=8)
               = align(W_out, 32)    … pool>1 且 fp16(保证写回行宽 ≥ 32 B)
  poolOutWidth = padOutWidth / poolSize        (pool=1 时就是 padOutWidth)
三个约束"逼"出了这两个宽度:
| 约束 | 后果 |
|---|---|
| cube 的 N 分形是 16 | N 取"一整行输出 + pad 到 16/32",不是 W_out 本身(W_out=222 → 224) |
DataCopyParams 的 blockLen 单位是 32 B DataBlock |
写回行字节数 poolOutWidth × ε 必须是 32 的整数倍:fp32 padOutWidth/2 = 8 元素 = 32 B ✅;fp16 小图 16/2 = 8 元素 = 16 B ❌ → 该档 padOutWidth 从 16 提到 32(poolOutWidth = 16) |
8.5 的 DataCopyPad 只有 GM→UB 方向 |
不做"奇数列写回",统一写 padded 行、host 裁列收尾 |
写回那条 DataCopy(单位全部按「字节数 / 32」算):
wp.blockCount = baseM;                                                  // 行数
wp.blockLen   = poolOutWidth * sizeof(T) / 32;                          // 每行占几个 DataBlock
wp.srcStride  = 0;                                                      // UB 侧行距 = poolOutWidth → 间隔 0
wp.dstStride  = (H_pool * poolOutWidth - poolOutWidth) * sizeof(T) / 32; // 目的行距 − 块长
dstOff        = b·C_out·H_pool·poolOutWidth + cout0·H_pool·poolOutWidth + ph·poolOutWidth;
以小图 fp32 / pool=2 为例:poolOutWidth=8 → blockLen = 8·4/32 = 1、dstStride = (15·8 − 8)·4/32 = 14。
host 回读后只做裁列:oHost_ 第 (b·C_out+co)·H_pool + ph 行的前 W_pool 个元素 ← oPadded 同行的前 W_pool 个元素(源行距 poolOutWidth),两侧行数都是 H_pool——maxpool 已在 kernel 里做完,host 不做任何归约。
④ UB 里的中间张量
| 缓冲 | 维度 | 用途 |
|---|---|---|
outQueue(C) |
baseM × padOutWidth |
GetTensorC 落点;池化后前 poolOutWidth 列是结果 |
tmpQueue |
baseM × padOutWidth |
pool>1:装第 2 个卷积行 → 行 max 结果 → 偶列紧凑落点 |
poolQueue |
baseM × poolOutWidth |
pool>1:奇列紧凑落点(GatherMask 的目标) |
biasQueue |
C_out |
bias 全量驻留 UB,池化后逐行 GetValue + Adds |
⑤ 四档配置的实际维度(作业测试的两种图 × 两种 dtype,pool=2;baseN = padOutWidth)
| 配置 | H_out×W_out → H_pool×W_pool | padOutWidth | poolOutWidth | baseM / baseN / baseK | tileRows → tilePoolRows | rIn | UB 预算 |
|---|---|---|---|---|---|---|---|
| 小图 fp32 | 30×14 → 15×7 | 16 | 8 | 64 / 16 / 64 | 16 → 8 | 18 | ≈ 10.5 KiB |
| 小图 fp16 | 30×14 → 15×7 | 32 | 16 | 128 / 32 / 128 | 16 → 8 | 18 | ≈ 20 KiB |
| 大图 fp32 | 222×222 → 111×111 | 224 | 112 | 64 / 224 / 64 | 16 → 8 | 18 | ≈ 141 KiB |
| 大图 fp16 | 222×222 → 111×111 | 224 | 112 | 128 / 224 / 128 | 16 → 8 | 18 | ≈ 140.5 KiB |
小图 fp16 的 padOutWidth = 32 就是上表"32 B 整数倍"那条约束的直接结果(大图的 224 天然满足)。UB 预算由 kernel 启动时打印的 [TILING] 行给出,超过平台读数会打 [WARN]。
2.2.4 上板验证命令
# ── 0. 环境准备(每个新 shell 一次)──────────────────────────────
export ASCEND_INSTALL_PATH=/usr/local/Ascend/cann-8.5.0    # 以本机 CANN 实际路径为准
source $ASCEND_INSTALL_PATH/bin/setenv.bash

# ── 1. 编译 ─────────────────────────────────────────────────────
# 手动编译(-v 是机型:A2 用 npu-smi 的 Name → Ascend910B4;
#        A3 用 ChipName_NPUName → Ascend910_9362,见 README-ASCEND.md 判机型)
bash run.sh --run-mode npu --build-only -v Ascend910B4
# 产物:build-npu/ascendc_kernels

# ── 2. 对比(正确性对拍,numpy + torch 双基准)──────────────────
# 改了代码后 → --build 强制重新编译;没改代码重复跑 → 直接 --quick/不带参数,
# test_harness 检测到 build-npu/ascendc_kernels 存在就自动跳过编译(不会重复构建)。
python3 test_harness.py --build --quick   # 改代码后:强制重编 + 小图对拍(bias=0/1 各 fp16/fp32)
python3 test_harness.py --quick           # 重复跑(跳过编译):只跑小图对拍

python3 test_harness.py                   # 全量:再加 224×224 大图 + bias(二进制存在则不重编)
python3 test_harness.py --test_maxpool    # 含 maxpool(pool=2 → 15×7 / 111×111)

# 手动单跑 + 落盘,再对拍(可调 tile 切分验证行切片正确性):
./build-npu/ascendc_kernels --dtype float32 --batch 4 --in-channels 128 --out-channels 128 \
    --height 32 --width 16 --filter 3 --pool 1 --block-dim 1 --warmup 1 --iters 1 --bias \
    --tile-batch 1 --tile-rows 16 --dump-dir /tmp/asst4p2
# → /tmp/asst4p2 下 x.bin / w.bin / bias.bin / out.bin
#   (手动跑记得 LD_LIBRARY_PATH 前缀追加 $PWD/build-npu/lib,见 2.4 第 12 条)
# 想验证"行切片"无边界问题,把 --tile-rows 改 1 / 2 / 7(不是 outHeight 的约数)重跑对拍,
# 结果应与整幅一次算完全一致(输出按全局 oh 偏移写回)。
输出结果:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part2$ python3 test_harness.py --build --test_maxpool
[info] soc_version = Ascend910B4
[info] 参考实现:numpy + torch 双基准(两者必须一致)
[build] bash /opt/atomgit/asst4-ascend/part2/run.sh --run-mode npu --build-only --soc-version Ascend910B4

=== 正确性用例 ===
[case] bias=0 maxpool=0 小图
  [ OK ] float32: 215040 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 215040 个元素全部匹配(rtol=atol=0.01)
[case] bias=0 maxpool=0 大图 224×224
  [ OK ] float32: 50466816 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 50466816 个元素全部匹配(rtol=atol=0.01)
[case] bias=0 maxpool=1 小图
  [ OK ] float32: 53760 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 53760 个元素全部匹配(rtol=atol=0.01)
[case] bias=0 maxpool=1 大图 224×224
  [ OK ] float32: 12616704 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 12616704 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=0 小图
  [ OK ] float32: 215040 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 215040 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=0 大图 224×224
  [ OK ] float32: 50466816 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 50466816 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=1 小图
  [ OK ] float32: 53760 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 53760 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=1 大图 224×224
  [ OK ] float32: 12616704 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 12616704 个元素全部匹配(rtol=atol=0.01)

正确性总判定: [ OK ] 全部通过
2.3 Optimization
本节给方案与判据:第一步(多核)已落地,后面每一步都按"先测 → 再剖 → 只改一个变量 → 复测"的节奏推进,实测表格随扫描补齐。
2.3.1 优化总览:先量什么、按什么顺序改
优化前先固定三个口径(都用现有工具,不需要额外埋点):
| 口径 | 怎么算 | 说明 |
|---|---|---|
| MFU | FLOPs / (t × 峰值) |
FLOPs harness 已打印;峰值 fp16 = 20 AIC × 16×16×16 MAC/cycle × f × 2,fp32 按 1/4 估,f 取 OpBasicInfo.csv 的 Current Freq(Part 1 §1.3 实测 1650 MHz) |
| 融合是否生效 | 实测 GM 读写量 vs 最小访存(x + w + out) | 用 Memory.csv 的 read/write_main_memory_datas;数量级大于最小访存 = 中间结果落了 HBM |
| 并行度够不够 | 每单元工作项数 / 核数 | kernel 启动时打印的 [TILING] 多核:… 一行直接给出 |
改的顺序(后者依赖前者的结论):
- 并行度(多核,§2.3.2)——20 个 AIC 一个都没吃满时,调片上参数是白费;
- 片上流水(
msprof op,§2.3.4)——cube / vector / MTE 谁在等谁; - host 侧与流水重叠(整体 timeline,§2.3.3)——设备有没有在等 host;
- tiling 参数(扫描矩阵,§2.3.5)。
2.3.2 第一步:多核
硬件:910B4(A2)= 20 个 AI Core;任务类型在两个 kernel 入口显式声明为 KERNEL_TASK_TYPE_DEFAULT(KERNEL_TYPE_MIX_AIC_1_2)(与官方样例同款),即每个 AIC 配 2 个 AIV(共 40 个)——这一行才是"20 cube + 40 AIV"的来源,不声明就只能按编译器推断的类型走、AIV 数量不保证。启动时只传 AIC 个数,AIV 由框架按 1:2 拉起,kernel 里不需要手动管 AIV。
工作项定义与分配(Process()):
工作项 = (batch, M 块, 池化行)                 // M 块 = 一段 baseM 个输出通道
items  = batchSize × (C_out / baseM) × tilePoolRows
for (it = blockIdx; it < items; it += blockNum)
    OneTile(b, mIdx · baseM, ph);              // 一核一项,写回区域互不重叠
- 三个分量正交切分 → 各核写的是不同的输出区域,不需要原子/同步;
- 用步进式(stride = blockNum)而不是块式:相邻工作项落在不同核上,同一时刻各核读的是同一片输入行,L2 命中更好。
这一步真正的坑:行 tile 太短 → 一半核闲着。 原来 host 固定 --tile-rows 16,而一个流水单元里能切出的工作项只有 (C_out/baseM) × tilePoolRows 个——小图 fp16 的 M 块只有 1 个(baseM=128=C_out),20 个核里最多用得上 8 个。所以把两个默认值都改成自动:
--block-dim 0  →  平台读数 GetCoreNumAic()(910B4 = 20)
--tile-rows 0  →  tileRows = max(16, ceil(cores / mBlocks) × pool)   // pool 对齐
                  ⇒ 保证每单元 工作项数 ≥ 核数,每核至少一项
kernel 启动时把结论打出来,直接核对:
[INFO ] 自动核数:blockDim=20(AIC;MIX_AIC_1_2 ⇒ AIV = 2×)
[TILING] 多核:blockDim=20(AIC;…);每单元工作项 = M块(2) × 池化行(16) × batch(1) = 32 → 每核 1.60 项
验证:
python3 test_harness.py --build --test_maxpool   # 正确性现在**默认就是多核**(切分本身也要验)
python3 test_harness.py --test_maxpool           # 含 224×224
python3 test_harness.py --perf --block-dim 1     # 单核基线(回归口径,也能复现旧行为)
python3 test_harness.py --perf                   # 自动核数(20)
输出结结果:
atomgit@6ac4a72a17ae8e63171149c9:~/asst4-ascend/part2$ python3 test_harness.py --perf
[info] soc_version = Ascend910B4
[info] 参考实现:numpy + torch 双基准(两者必须一致)

=== 正确性用例 ===
[case] bias=0 maxpool=0 小图
  [ OK ] float32: 215040 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 215040 个元素全部匹配(rtol=atol=0.01)
[case] bias=0 maxpool=0 大图 224×224
  [ OK ] float32: 50466816 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 50466816 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=0 小图
  [ OK ] float32: 215040 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 215040 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=0 大图 224×224
  [ OK ] float32: 50466816 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 50466816 个元素全部匹配(rtol=atol=0.01)

=== 性能用例 ===
注意:Trainium2 版给出的参考阈值(4596 / 1002 μs 等)是特定硬件的实测值,
      在昇腾上无意义。下面是本机的实测值,MFU 需要你自己按机型峰值算。

  float16  32× 16 pool=1  median=   5779.9 us    85.72 GFLOP/s    0.29 GB/s  baseM/N/K=128×16×128  blockDim=1
  float32  32× 16 pool=1  median=   5462.8 us    90.70 GFLOP/s    0.61 GB/s  baseM/N/K=64×16×64  blockDim=1
  float16  224×224 pool=1  median=  63660.0 us   913.25 GFLOP/s    0.82 GB/s  baseM/N/K=128×224×128  blockDim=1
  float32  224×224 pool=1  median= 102965.5 us   564.63 GFLOP/s    1.01 GB/s  baseM/N/K=64×224×64  blockDim=1
  float16  224×224 pool=2  median=  61475.6 us   945.70 GFLOP/s    0.54 GB/s  baseM/N/K=128×224×128  blockDim=1
  float32  224×224 pool=2  median= 102121.5 us   569.30 GFLOP/s    0.65 GB/s  baseM/N/K=64×224×64  blockDim=1

正确性总判定: [ OK ] 全部通过
2.3.3 整体 profile:host + kernel 一条时间线
目的:回答"设备有没有在等 host"。host 侧每单元要先做一次纯 CPU 的 RepackIm(小图就是 6912 次 64 B 的 memcpy)再发 H2D;一旦它慢于 kernel,设备就会空转——而只看 median(含 host 开销)或只看 msprof op(只有算子)都看不出这件事。
cd part2 && source $ASCEND_HOME_PATH/bin/setenv.bash
# 具体采集项以 `msprof --help` 为准(8.5/9.0 的选项名略有差异)
msprof --application="bash -c './build-npu/ascendc_kernels --dtype float16 --batch 1 \
        --in-channels 256 --out-channels 256 --height 224 --width 224 --filter 3 --pool 2 \
        --block-dim 0 --warmup 5 --iters 20'" \
       --output=./profile/overall \
       --runtime-api=on --task-time=on --ai-core=on --sys-cpu-profiling=on
要读三件事:
| 看什么 | 在哪看 | 判读 |
|---|---|---|
| 相邻 kernel 之间有没有空隙 | timeline 上 kernel 条的间隔 | 有空隙 = H2D/host 没跟上(对照 2.4.1 修完的同步,确认重叠度) |
| host API 密度 | --runtime-api=on 的 aclrtMemcpyAsync / launch 记录 |
单位时间里 API 很密 = host 侧是瓶颈 |
| 每个 task 的时长 | --export=on 的 task 表 / MindStudio Insight |
与 §2.3.5 的理论下界对比 |
MindStudio Insight 离线打开产出目录即可——不需要 InfluxDB、不需要 SSH 端口转发(与 Part 1 §1.3 同一套用法)。
2.3.4 算子级 profile:msprof op
Part 1 §1.3 已验证过两种调用形式,直接复用:
# 形式 1:包一个 shell 脚本
msprof op --output=./profile --application=./prof_run.sh
# 形式 2:直接跑可执行(推荐,参数写全便于复现)
msprof op --output=./profile ./build-npu/ascendc_kernels \
    --dtype float16 --batch 1 --in-channels 256 --out-channels 256 --height 224 --width 224 \
    --filter 3 --pool 2 --block-dim 0 --warmup 5 --iters 20
# 只想看某一次 launch(跳过 warmup,避免 20 次混在一起):
msprof op --output=./profile --kernel-name=fused_conv2d_maxpool_fp16 \
    --launch-skip 5 --launch-count 1 <app> <args...>
产出 OPPROF_<时间戳>_<随机串>/,本算子该看的字段(按"想验证什么"分组):
| 想验证 | 看哪个 CSV / 字段 | 判读 |
|---|---|---|
| cube 是否吃饱 | PipeUtilization:aic_mac_ratio、aic_mte1/2_ratio、aic_fixpipe_ratio |
mac 低而 mte2/fixpipe 高 → 卡在搬运,或卡在 L0C→UB 回拷 |
| AIV(池化 + bias)是否拖后腿 | aiv_vec_ratio、aiv_scalar_ratio、aiv_mte3_ratio |
scalar 高 = 指令/同步开销大(每工作项 64 次 GetValue+Adds 正是这一类) |
| 访存总量对不对 | Memory:read/write_main_memory_datas |
与最小访存比:≈ x+w+out 才算融合成功 |
| 写回带宽 | UB_to_GM_bw_usage_rate、GM_to_UB_bw_usage_rate |
配合"最小访存 ÷ 时长"反推有效带宽,与机型带宽比 |
| bank conflict | ResourceConflictRatio:vec_bank_conflict_ratio 等 |
高就调 UB 内张量的偏移/对齐 |
| 启动地板 | OpBasicInfo:Task Duration 对比手上 median |
差得多 = host/启动开销占比高 |
msprof op只看算子——host 侧的 Repack/同步它不采,那部分必须用 §2.3.3 的方式。两者配合才能回答"瓶颈在设备还是在上游"。
2.3.5 扫描矩阵与判据
先算三个数(都能从上面两份产出里凑出来):MFU、实现带宽 = 最小访存 / t、items/核。然后按顺序扫,每次只改一个变量:
| 轮次 | 变量 | 取值 | 期望看到 |
|---|---|---|---|
| 1 | --block-dim |
0(auto=20) / 1 / 2 / 4 / 8 / 16 | 加速比是否接近线性;items/核 ≥ 1 才可能线性 |
| 2 | --tile-rows |
0(auto) / 16 / 32 / 64 | 单元数 ↔ 核占用 ↔ HBM 峰值的权衡;配合 timeline 看重叠 |
| 3 | --base-m |
fp16: 64/128,fp32: 32/64 | UB 预算与 L0C 占用;aic_mac_ratio 是否上升 |
| 4 | --base-k |
64 / 128 | L1↔L0 往返次数;aic_mte1_ratio |
| 5 | --pool |
1 / 2 | 池化段(vector)的相对代价 |
| 6 | --tile-batch |
1 / 2 / 4 | host 侧 Repack 次数与重叠度 |
2.3.6 后续优化候选(按预期收益排序,附判据)
| # | 候选 | 为什么值得做 | 怎么验 / 风险 |
|---|---|---|---|
| 1 | 只在最后一次取 C | 现在 9 次 (i,j) 每次都 GetTensorC,L0C→UB 被拷 9 遍(大图每次 56 KB、×9)。中间 8 次其实只需累加:Iterate<false>(true)(异步、不取) |
看 aic_fixpipe_ratio 与 Task Duration 是否下降。风险:2.4 第 10 条记过"只 Iterate 不取会挂",必须先做小实验确认 |
| 2 | bias 交给 fixpipe | 现在 bias 由 AIV 逐行 GetValue + Adds(每工作项 64 次标量发射);改用 SetBias + tilingApi.SetBias(true),由 fixpipe 在 L0C→UB 时加 |
aiv_scalar_ratio 应明显下降。必须与候选 1 同做:否则 partial sum 每次 GetTensorC 都会被加一遍 bias |
| 3 | 权重(A)复用 | 同一 M 块、不同 ph 的工作项用的是同一份 W′[(i,j)] 切片;工作项顺序已让 ph 变化最快,若框架"地址没变就复用 L1"即可省 mte2 |
看 aic_mte2_ratio;不行就显式按 M 块分组调度 |
| 4 | K 一次装完 | 大图 baseN=224 时 baseK 被 baseK×baseN ≤ 64 KB/ε 卡在 128(fp16)/64(fp32),K=256 要搬两轮。把 N 降到半行 112 后 fp16 可 baseK=256 一次装完(128×256=32768 刚好顶格);fp32 上限更紧(256×112=28672>16384),仍要两轮 |
扫 --base-n 112,看 mte1 降多少、fixpipe/写回次数涨多少 |
| 5 | host 侧 | RepackIm 是纯 CPU 的逐元素 memcpy;同一份数据在双缓冲下会被重排两遍。可整行 memcpy(W 是 16 的倍数时)、host 缓冲扩到 4 份恢复重叠度 |
整体 timeline 的 kernel 空隙 + median 与 kernel 净耗时之差 |
| 6 | 写回合并 | 小图一行只有 1 个 32 B DataBlock,写回次数偏多;可把同一 cout0 的多个 ph 攒起来一次写 |
UB_to_GM_bw_usage_rate、aiv_mte3_ratio |
2.4 排障总结:易错点与注意事项
2.4.1 排障实录:双缓冲流水的 host 缓冲复用竞态
对应代码:
conv2d.asc的FusedConv2dMaxpoolHost::LaunchOneIter()(host 双缓冲流水)。 这条同时是 2.2.3 里"i 冗余消除 + tile 行切片"落地后踩的坑:症状只在多流水单元时出现,单块配置全对。
现象(行切片 + 双缓冲流水落地后第一次跑,python3 test_harness.py --build --quick):
[case] bias=0 maxpool=0 小图
  [FAIL] float32: 最大绝对误差 32.7,首个不符位置 67235(实际 276.136,期望 308.833)
[case] bias=1 maxpool=0 小图
  [FAIL] float32: 最大绝对误差 322.5,首个不符位置 68223(实际 0.197121,期望 322.657)
正确性总判定: [FAIL] 存在不通过的用例
第 1 步:先把「布局 / 重排」排除掉(没有卡也能做)
- kernel 的输入是确定性 LCG 造的(seed
12345 / 67890 / 24680)。按同一套种子在 numpy 里重建落盘张量,直接复现出报错里的两个「期望」:308.83258(@67235)与322.65738(@68223)⇒ 两次运行喂给 kernel 的 x/w 逐字节相同,两者之间只差 bias 那 128 个数。 - 把 host 的
RepackIm/RepackW与 kernel 的imOff/dstOff地址公式原样搬到 numpy 重放整条链路:与参考实现max|Δ| = 1.2e-4(fp32 尾数级)⇒ 「行位移 i 折进行索引 + tile 行切片」这次重排在数学上等价,布局可以排除。 - 反解失败位置:
67235 = ((1*128+32)*30+2)*14+7、68223 = ((1*128+34)*30+13)*14+1;「实际 0.197121」恰好等于bias[34],而 322.5 正好是该输出行 conv 的最大值 ⇒ 整行(b=1, oh=13)的 conv 贡献全为 0。把整行置 0 重放:坏点 1792、max err 322.5、argmax 落在(co=34, ow=1),与报错逐位一致。 - 但 case1 的最大误差只有 32.7(≈ 一个
(i,j)项的量级),没有任何一行整行为 0 ⇒ 同一份输入、同一条 kernel,两次运行的损伤形态不同 ⇒ 输出不是输入的确定性函数。
第 2 步:用 diag_part2.py 三分法二分(Q1 确定性 / Q2 损伤图 / Q3 退化流水切块;脚本见 part2/diag_part2.py)
修复前:
$ python3 diag_part2.py
=== Q1:同一参数连跑 3 次,out.bin 是否一致 ===
  run0: md5=afc3b9d52efcdf1f30a1fe1a325a6a74
  run1: md5=bf24bd2a1cf0e33cc453656395c64e5c
  run2: md5=bf24bd2a1cf0e33cc453656395c64e5c
  结论:**不确定**(每次不同)→ 设备侧同步/竞态(AIC↔AIV 或流水覆写)

=== Q2:损伤图 ===
[case] bias=0
  坏点 107440 / 215040(49.963%),最大绝对误差 208.9
  按 batch 分布(每 batch 53760 点):[0, 53726, 53714, 0]
  '输出 == bias'(该点 conv 贡献为 0)的点数:0
[case] bias=1
  坏点 107436 / 215040(49.961%),最大绝对误差 32.7
  按 batch 分布(每 batch 53760 点):[0, 53722, 53714, 0]
# (损伤行列表略:b=1/b=2 的每一行都是 ~1790/1792 坏,b=0/b=3 一行都没有)

=== Q3:改流水切块,看损伤是否消失 ===
[单行 tile(--tile-rows 30)]      坏点 0 / 215040(0.000%),最大绝对误差 0.0001221
[--tile-rows 7]                    坏点 162907 / 215040(75.757%),最大绝对误差 33.02
[单 batch tile(--tile-batch 4)]  坏点 0 / 215040(0.000%),最大绝对误差 0.0001221
[两者都退化]                       坏点 0 / 215040(0.000%),最大绝对误差 0.0001221
三条判据:
- Q1 三次 md5 不一致 ⇒ 竞态,不是纯逻辑 bug;
- Q2 坏点在 batch 维度成块(
[0, 53726, 53714, 0]:b=0/b=3 全对、b=1/b=2 几乎全错),且最大误差落在"整行 conv 为 0"这一形态上; - Q3 一旦退化成 ≤4 个流水单元就全部正确(残差只剩 fp32 尾数
1.2e-4)⇒ 故障在 host 双缓冲流水,与 kernel 的计算逻辑无关(期间怀疑过的「9 次GetTensorC+ UBAdd累加」与「缺 MIX 任务类型声明」由此排除)。
第 3 步:根因 —— host 缓冲只有 2 份,而 CPU 不受 stream 顺序约束
- 把「unit 2/3 的 H2D 实际读到的是 unit 6/7(即 b=3)的打包数据」建成模型,逐行最大误差与 diag 观测的 24 行中 22 行逐位相同(
18.8 24.6 32.7 32.7 25.8 …/21.8 19.3 25.9 27.1 …)——不是巧合。 - 机制:
imPackedHost_[p]只有 2 份,而RepackIm是先memset全 0、再逐段填;H2D 是异步的,又被aclrtStreamWaitEvent(copyStream_, calcEv_[p])挡在copyStream队列里可能尚未执行;与此同时 CPU 侧的三个调用全是异步入队,CPU 会一路RepackIm跑到后面第 4 个单元去。等 DMA 真正开跑,缓冲里已经是后面那个单元的数据——甚至只是memset出来的全 0(这正是"整行 conv 为 0"、输出恰好等于 bias 的来源)。 - 为什么首尾 batch 看起来没事:unit 0/1 的拷贝排在空队列上立即执行;unit 6/7 之后 CPU 已无后续
RepackIm。只有中间"被卡在队列里"的单元才会读到被提前覆盖的缓冲。 - 设备缓冲那半条保护是对的(
aclrtStreamWaitEvent(copyStream_, calcEv_[p])),缺的是 host 这半条。
第 4 步:修复(conv2d.asc,两处)
// ① RepackIm 之前:host 阻塞,等 unit-2 那次 H2D 真正读完这块 host 缓冲
if (unitIdx >= 2) {
    aclrtSynchronizeEvent(copyEv_[p]);
}
// ② 每轮收尾:连 copyStream 一起同步(跨轮次复用 host 缓冲的窗口)
aclrtSynchronizeStream(calcStream_);
aclrtSynchronizeStream(copyStream_);
代价:CPU 不再能"领先 2 个单元以上"(本来就是 2 份缓冲的语义)。要恢复重叠度,把 host 缓冲扩成 4 份、每份配一个 event 即可,代价只是几 MB 主机内存。
第 5 步:修复后复跑
$ python3 diag_part2.py --skip-variants
=== Q1:同一参数连跑 3 次,out.bin 是否一致 ===
  run0: md5=a90e72214417ebd4d7adc3e577cf7623
  run1: md5=a90e72214417ebd4d7adc3e577cf7623
  run2: md5=a90e72214417ebd4d7adc3e577cf7623
  结论:**确定性**(每次完全相同)→ 查地址/布局(读到别人的数据/越界)
# (Q1 的结论行是脚本的机械提示语:确定性 + 下面 Q2 的 0 坏点 = 已修好)

=== Q2:损伤图 ===
[case] bias=0
  坏点 0 / 215040(0.000%),最大绝对误差 0.0001221
  按 batch 分布(每 batch 53760 点):[0, 0, 0, 0]
  '输出 == bias'(该点 conv 贡献为 0)的点数:0
[case] bias=1
  坏点 0 / 215040(0.000%),最大绝对误差 0.0001221
  按 batch 分布(每 batch 53760 点):[0, 0, 0, 0]
  '输出 == bias'(该点 conv 贡献为 0)的点数:0
$ python3 test_harness.py --quick
[info] soc_version = Ascend910B4
[info] 参考实现:numpy + torch 双基准(两者必须一致)

=== 正确性用例 ===
[case] bias=0 maxpool=0 小图
  [ OK ] float32: 215040 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 215040 个元素全部匹配(rtol=atol=0.01)
[case] bias=1 maxpool=0 小图
  [ OK ] float32: 215040 个元素全部匹配(rtol=atol=0.01)
  [ OK ] float16: 215040 个元素全部匹配(rtol=atol=0.01)

正确性总判定: [ OK ] 全部通过
这一条的普适教训:异步拷贝有两端缓冲,两端要分别写保护——设备缓冲靠 stream 事件(aclrtStreamWaitEvent),host 缓冲只能靠 host 侧阻塞(aclrtSynchronizeEvent)。只做前者时,只要 CPU 比"被事件卡住的拷贝"跑得快,就会把还在队列里等着被读的 host 缓冲覆盖掉;症状是"数值看起来像另一个 tile / 一片 0",且随流水切块方式而变——先看 --tile-rows / --tile-batch 退化后是否消失,就能一刀切开 host 流水与 kernel 逻辑。
构建 / 启动层(症状:kernel 不执行、进度字恒 0、stream 挂):
- 构建流:CANN 8.5 用官方第二代 ASC 语言流(
find_package(ASC)+.asc单文件,kernel 与 hostmain同文件),不要用第一代ascendc_library(auto_gen)——它对 MIX/高阶 API kernel 的注册失败(RegisterAscendBinary mix ret 107000),任务贴了但设备端不执行。 - 链接器:用
bisheng链接(纯 ASC target 自动、混合 target 设LINKER_LANGUAGE ASC)。它自带 CANN 库搜索路径并解析.so传递依赖;用 GNU ld 会一路缺libregister / libascendcl / libunified_dlog / libc_sec。 - tiling 传参:kernel 入口的 tiling 必须按值结构体传(
AscendC::tiling::TCubeTiling tiling)。GM 缓冲 + 入口 DecodeTiling 的形式在 8.5 下任务静默不执行。 - REGIST 位置与 workspace:
REGIST_MATMUL_OBJ(&pipe, GetSysWorkSpacePtr(), mm, &tiling)必须在入口函数内、workspace 用GetSysWorkSpacePtr()(__kfc_workspace__参数)。把自 malloc 的 workspace 值传进去会在 REGIST 死锁。 - 不要用
isTransposeB=true:实测在 8.5 下 C 只会算出第 1 列(N 方向丢失,其余为垃圾)。B 直接给(K,N)row-major 连续段、isTransposeB=false——官方样例(02/03)全部如此。"把转置交给框架"的小聪明在小 N 上翻车。
数据排布(症状:数值系统性偏差、无 pattern):
- B 段 =
(Cin, OWp)连续(host 预排布):每个(i,j)一个段,段内通道主序、OWp列连续;输入列越界(ow'+j ≥ W)补 0。这才是"零搬运 shift"的官方形态(配合 5 的isTransposeB=false)。 RepackW必须逐元素拷贝:权重是 4 维(C_out, C_in, FH, FW),c的存储步长是FH*FW=9——一行memcpy拷C_in个"连续"字节会把c拷成错序。所有多维重排都要按源步长逐元素写,不能靠连续 memcpy。症状:值量级全对(5–35% 随机偏差、co 相关),排查极难。DataCopyParams的单位是 32 B DataBlock:blockLen / srcStride / dstStride都按「字节数 / 32」算,不是「元素数 / 16」。fp32 按OWp/16写blockLen会每行只搬半行(列 0..7 有值、其余 0)。
kernel 结构(症状:输出 ≈ 单次 (i,j)、或卡死):
- 跨
FH*FW次 (i,j) 复用同一 Matmul 对象:GetTensorC的"首块"判定用跨循环的step(cLocal 是否已初始化),不要用 while 内的subCnt——否则每个 (i,j) 都覆盖 cLocal、FH*FW项从不累加。 while(Iterate)每轮必须GetTensorC:只 Iterate 不取、或多次 Iterate 后取,会挂起。GetTensorC(dst, 0, true)的enSequentialWrite=true照官方。- 写回:输出用 padded 布局(matmul 的 N 直接取
OWp=align16(W_out)),一条带步长 DataCopy 落 GM、host 裁列——避免奇数列的 DataCopyPad 问题(8.5 的 DataCopyPad 只有 GM→UB 方向)。
运行 / 调试:
- 环境变量:
setenv.bash的完整LD_LIBRARY_PATH不能覆盖(CANN 库散在lib64、devlib、lib64/plugin/*、opp/...等多处);手动跑用「前缀追加」$PWD/build-npu/lib:$LD_LIBRARY_PATH;ASCEND_INSTALL_PATH每开新 shell 要重设。 - kernel 挂起时的调试手段:
AscendC::printf在挂起时不 flush(看不到)→ 用「GM 进度字 + host 不 sync 轮询」(kernel 每阶段写 magic 到 GM 尾部,hostaclrtMemcpy轮询读回);隔离写回用「Duplicate填 UB 全 1.5」实验;对账用「设备采样 vs host 按同一布局重现」——这次正是靠后者揪出RepackW的错序拷贝。
host 双缓冲流水(症状:随 --tile-rows/--tile-batch 变化、同一参数连跑两次 out.bin 都不一样):
- host 缓冲也要写保护:
imPackedHost_[p]复用前必须aclrtSynchronizeEvent(copyEv_[p])让 host 阻塞,且要放在RepackIm之前;每轮末尾再补aclrtSynchronizeStream(copyStream_)。只做设备侧那半条(aclrtStreamWaitEvent),CPU 一旦跑过被事件卡住的拷贝,就会把还在队列里等着被读的 host 缓冲覆盖掉。完整实录见 §2.4.1。